资料更新至2026年9月22日
这篇文章可以有两种读法。
如果已经玩过Ollama、LM Studio、ComfyUI,知道27B、GGUF、量化、显存这些词是什么意思,可以先翻到中间的模型表,再看后面两台机器的实测。那里数字多一些,也更接近实际使用。
如果平时只是用ChatGPT、DeepSeek、豆包,从头看也行。
前些天,有人问我:“现在本地能跑的大模型都有些什么?语言、推理、图片、视频,是不是都有?”
这个问题听起来很宽,里面其实装着几件不同的事。
这几年“大模型”三个字用得很宽。写文章的是大模型,看图片的是大模型,画图、做视频的,也被一股脑装进这个筐里。真把它们摊开,其实是一屋子不同的东西。
所以不妨先不管名字,只看它们会干什么。
普通人最熟悉的当然是聊天模型。问一句,它答一段。后来会写材料,会翻译,会编程序,会算题。于是“大模型”很容易被理解成一个知识很多、越来越聪明的聊天机器人。
现在已经不大是这样了。
按人的能力粗略地分:语言模型管读写,推理模型管想事情,视觉模型管看,语音模型管听和说。图像模型负责画。视频模型麻烦一些,得把画面沿着时间一帧一帧往前铺。Embedding和Reranker不怎么露脸,却天天躲在知识库后面帮人找资料。再把这些东西接上程序、数据库和工具,就是现在常说的Agent。
这些原来分开的东西,也开始往一起长。
2026年8月公开的Qwen3.8-27B就是一个例子。它是27B的稠密模型,但已经不是单纯的文字模型,原生带有多模态能力,同时面向代码、办公和长任务Agent做了优化,原生上下文达到262K。
再往前走,是Qwen3-Omni这一类全模态模型。文字、图片、声音、视频都可以进来,文字和语音又可以出去。只是“什么都会”的代价也很直白:机器要跟得上。本事大,胃口也大。
与此同时,另一个方向却越来越小。
文档识别的PaddleOCR-VL-1.6核心VLM只有0.9B,却专门处理文字、表格、公式、图表和印章;官方在OmniDocBench v1.6上的结果达到96.33%。 图像这边,FLUX.2 [klein] 4B已经能在约8GB显存的消费级GPU上做图片生成和编辑,而且4B版本采用Apache 2.0许可。
一边越来越大,一边越来越小。
倒也不矛盾。一个心气高,想当通才;一个肯本分,把一件事干利索。
模型太多,列全已经没有多大意义。今天列五十个,下个月又多二十个。下面只挑一些现在有代表性,而且确实和本地部署有关的东西。
| 想让AI干什么 | 代表模型 | 规模 | 本地部署大致情况 | 备注 |
|---|---|---|---|---|
| 文字、代码、推理、看图 | Qwen3.8-27B | 27B Dense | 量化后已进入高端消费级显卡或大统一内存设备范围 | Apache 2.0;适合做本地主模型。 |
| 纯文字推理、Agent | gpt-oss-20b | 约21B总参数,3.6B激活 | 官方面向16GB级内存部署 | 适合轻一些的本地推理与工具调用 |
| 只做判断 | Laya | 421M;多语言版322M | 很轻,单次前向直接返回概率 | Apache 2.0;100+语言版上下文1024。 |
| 结构化决策 | Jev | 未公开 | 目前为托管服务,不能本地部署 | System One代表,不生成自由文本。 |
| 听和说 | SenseVoice / FunASR + CosyVoice | 小型~1B级 | 普通GPU甚至CPU即可起步 | ASR与TTS最好仍交给专用模型。 |
| 全模态交互 | Qwen3-Omni | 30B-A3B级 | 更适合高端工作站、服务器 | 文字、图片、音频、视频统一处理 |
| PDF、表格、公式、印章 | PaddleOCR-VL-1.6 | 0.9B VLM | 很轻 | 文档解析专用。 |
| 图片生成和编辑 | FLUX.2 [klein] 4B | 4B | 约8GB VRAM | Apache 2.0;消费级GPU友好。 |
| 视频+声音生成 | LTX-2.5 | 22B DiT + 文本编码器等 | 需要较强GPU和内存卸载能力 | 可以本地自托管,采用LTX Community License。 |
| 文本/图像生成视频 | Wan2.2 TI2V-5B | 5B | 官方最低路线为24GB级显卡+offload;实际稳定性与版本、分辨率和内存配置有关 | 官方配置为24fps、121帧等;24GB机型也有OOM报告。 |
| 企业知识库 | Qwen3 Embedding / Reranker | 0.6B / 4B / 8B | 很轻到中等 | 一个负责找,一个负责把结果重新排好。 |
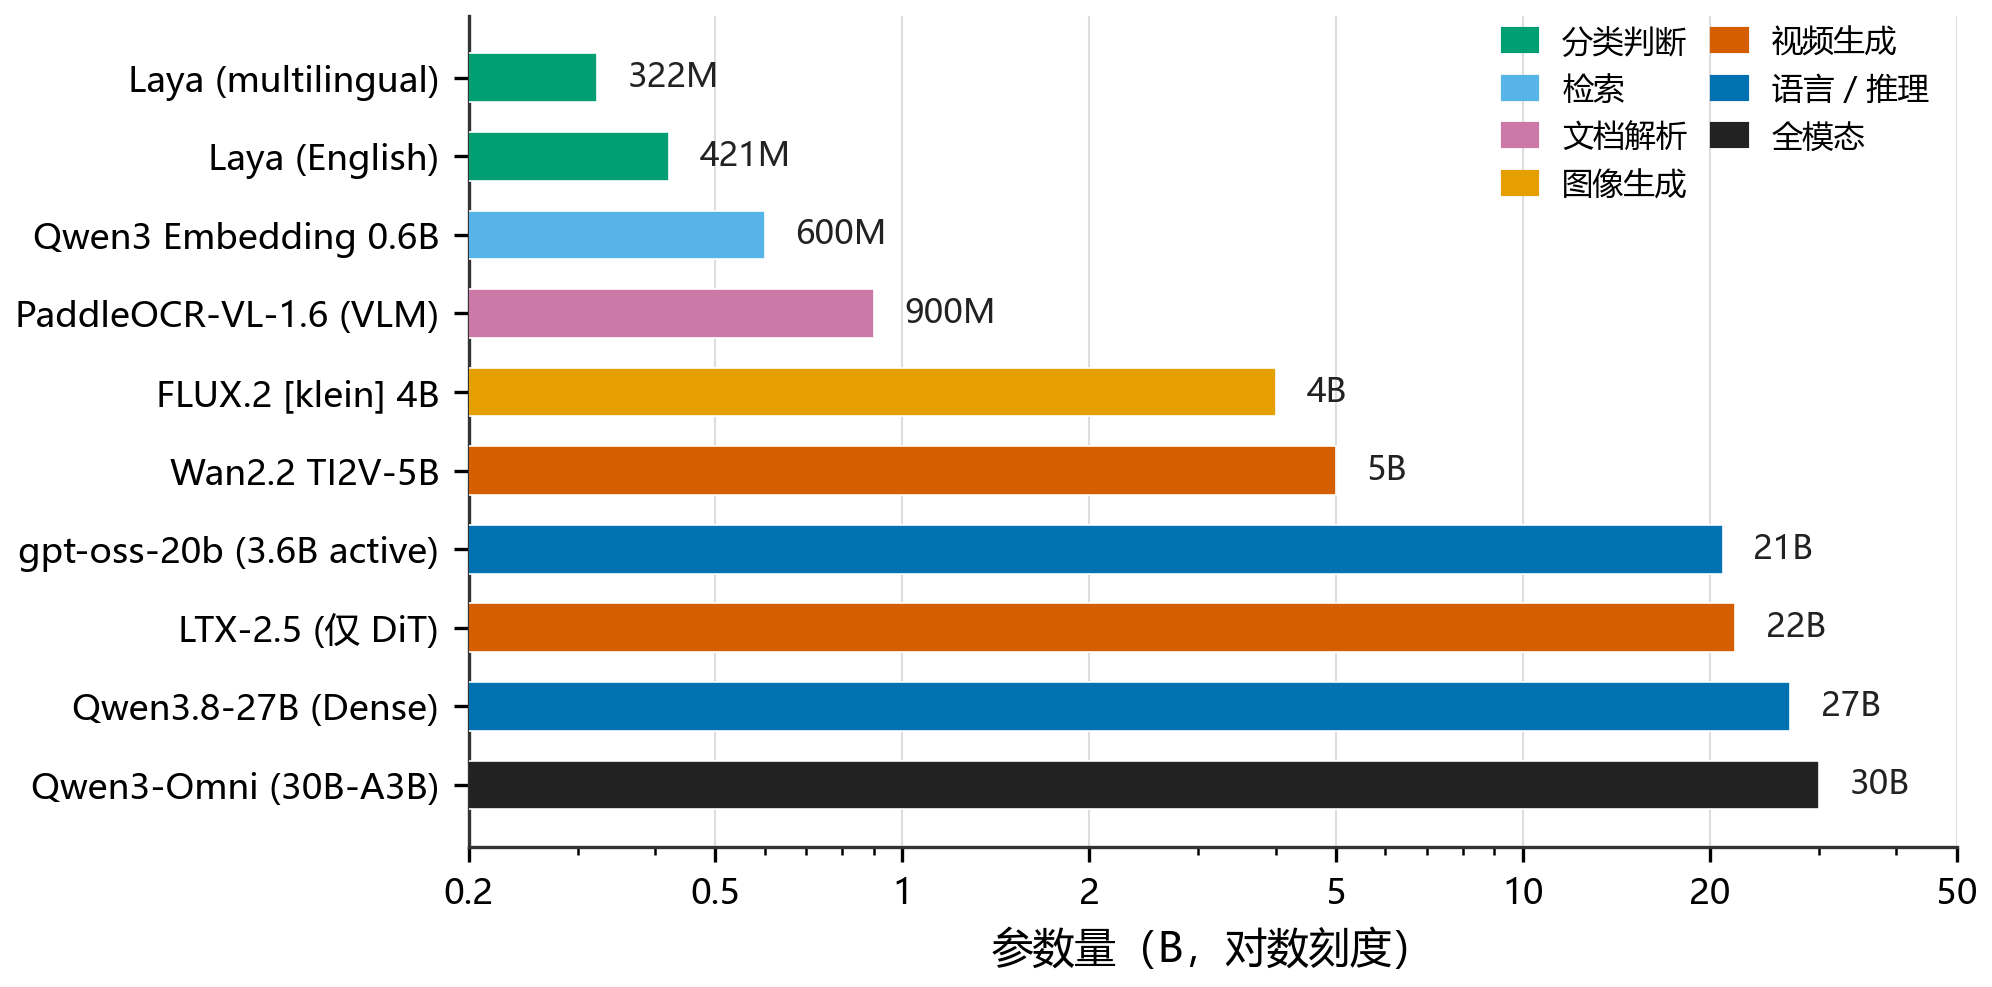
把这张表里的代表模型按参数规模画出来,是下面这个样子:
图1 代表性本地部署模型的参数规模(对数刻度),按用途着色。 从322M的分类模型到30B的全模态模型,跨度接近两个数量级。注意:参数量仅用于展示规模跨度,Encoder、DiT、Dense、MoE是不同架构,同样的参数量不能直接换算成速度、显存占用或能力;LTX-2.5此处只计22B DiT。
这张表里有一个挺有意思的地方:模型大小和工作的重要程度没什么简单关系。
一份合同很重要,但把里面的表格和印章提出来,不一定需要几十B模型。企业知识库很重要,真正天天跑在底下的Embedding也可能只有0.6B。反过来,一段六秒钟的视频,算起来却能让一张高端显卡忙上好几分钟。
AI慢慢有了一点工具箱的样子。
锤子还是锤子,螺丝刀还是螺丝刀。都做成瑞士军刀,未必好用。
9月份有两个模型让我觉得挺有意思。
一个叫Jev。
TypeSafe在9月15日发布了它,并给这一类东西起了一个名字:System One Model。Jev不负责和人聊天,也不打算写一篇漂亮文章。给它一段状态,再给几个问题,它直接返回类型明确的选择、分数和概率。TypeSafe自己的说法是:unstructured state in,typed probabilistic decisions out。
例如一封客户邮件进来,系统其实只想知道三件事:该转哪个部门,紧不紧急,要不要人工介入。传统LLM也能做,只不过它本质上还是在一个token接一个token地生成文字,然后程序再从文字里面把答案捞出来。
Jev把中间那篇作文去掉了。
这也解释了为什么TypeSafe会强调速度。官方给出的System One任务端到端时间大约70—500毫秒,并把结构化决策和概率置信度作为核心设计。
他们还用了一个很醒目的词:“Zero Hallucinations”。
我觉得这句话放在工程里理解比较合适。它不会突然多写一个不存在的答案,也不会跳出事先规定好的类型;可是一次判断仍然可能判断错。“报警概率93%”可以格式完全正确,同时事情本身判断错了。这是两回事。
随后出现的Laya就更有意思。它把类似思路做成了开放模型。英文版421M,多语言版322M;不是自回归生成,而是一次前向同时处理问题并返回概率。官方在Tesla T4上的数据,多语言版单问题约32.8毫秒,十个问题一起处理约72.3毫秒。
Laya Multilingual的模型卡称覆盖100多种语言,公开的跨语言评测目前主要覆盖51种。它很快,也很小,但模型卡自己也提醒:它可能给出高置信度的错误答案,概率并非天然可信,放到实际业务数据上,仍需重新做校准。
它让我想起一个很普通的事实:办公室里不是每件事情都需要写报告。有些事,只需要有人看一眼,说“是”“不是”“拿给老王”。
模型大概也一样。
真开始在自己电脑上装模型以后,很快会发现,27B、48GB、16GB这些数字只说了一半。
我手上正好有两台很不一样的机器。
一台Mac mini,M4 Pro,48GB统一内存,内存带宽273GB/s。另一台Windows笔记本,i9-12900H,RTX 3080 Ti Laptop,16GB显存,64GB系统内存。
单看数字,很容易觉得48GB的Mac什么都应该比16GB显存的笔记本宽裕。
实际不是。
我先在Mac mini上折腾Qwen3.8-27B。llama.cpp跑Q6_K,模型大约23.9GB,生成速度9—15 token/s。后来试Splash的Q4加DFlash2投机解码,官方在M5 Pro上的成绩很好,可到了我的M4 Pro,中文只有12 token/s,英文18,四路并发大约20。原因最后落到一个很具体的地方:草稿接受率只有13%—27%。投机模型先猜了一遍,大部分答案又被正式模型扔掉。猜是猜了,白猜一场。
再后来换omlx,利用Qwen3.8自己带的MTP头。修好Metal自定义内核,又把默认关闭的MTP打开,单路中文最后到了22.2 token/s,英文21.4;四路并发总吞吐30.8。MTP的接受率这时到了70%—77%。同一台机器,同一个27B模型,换了量化、引擎和解码方式,速度大约翻了一倍。
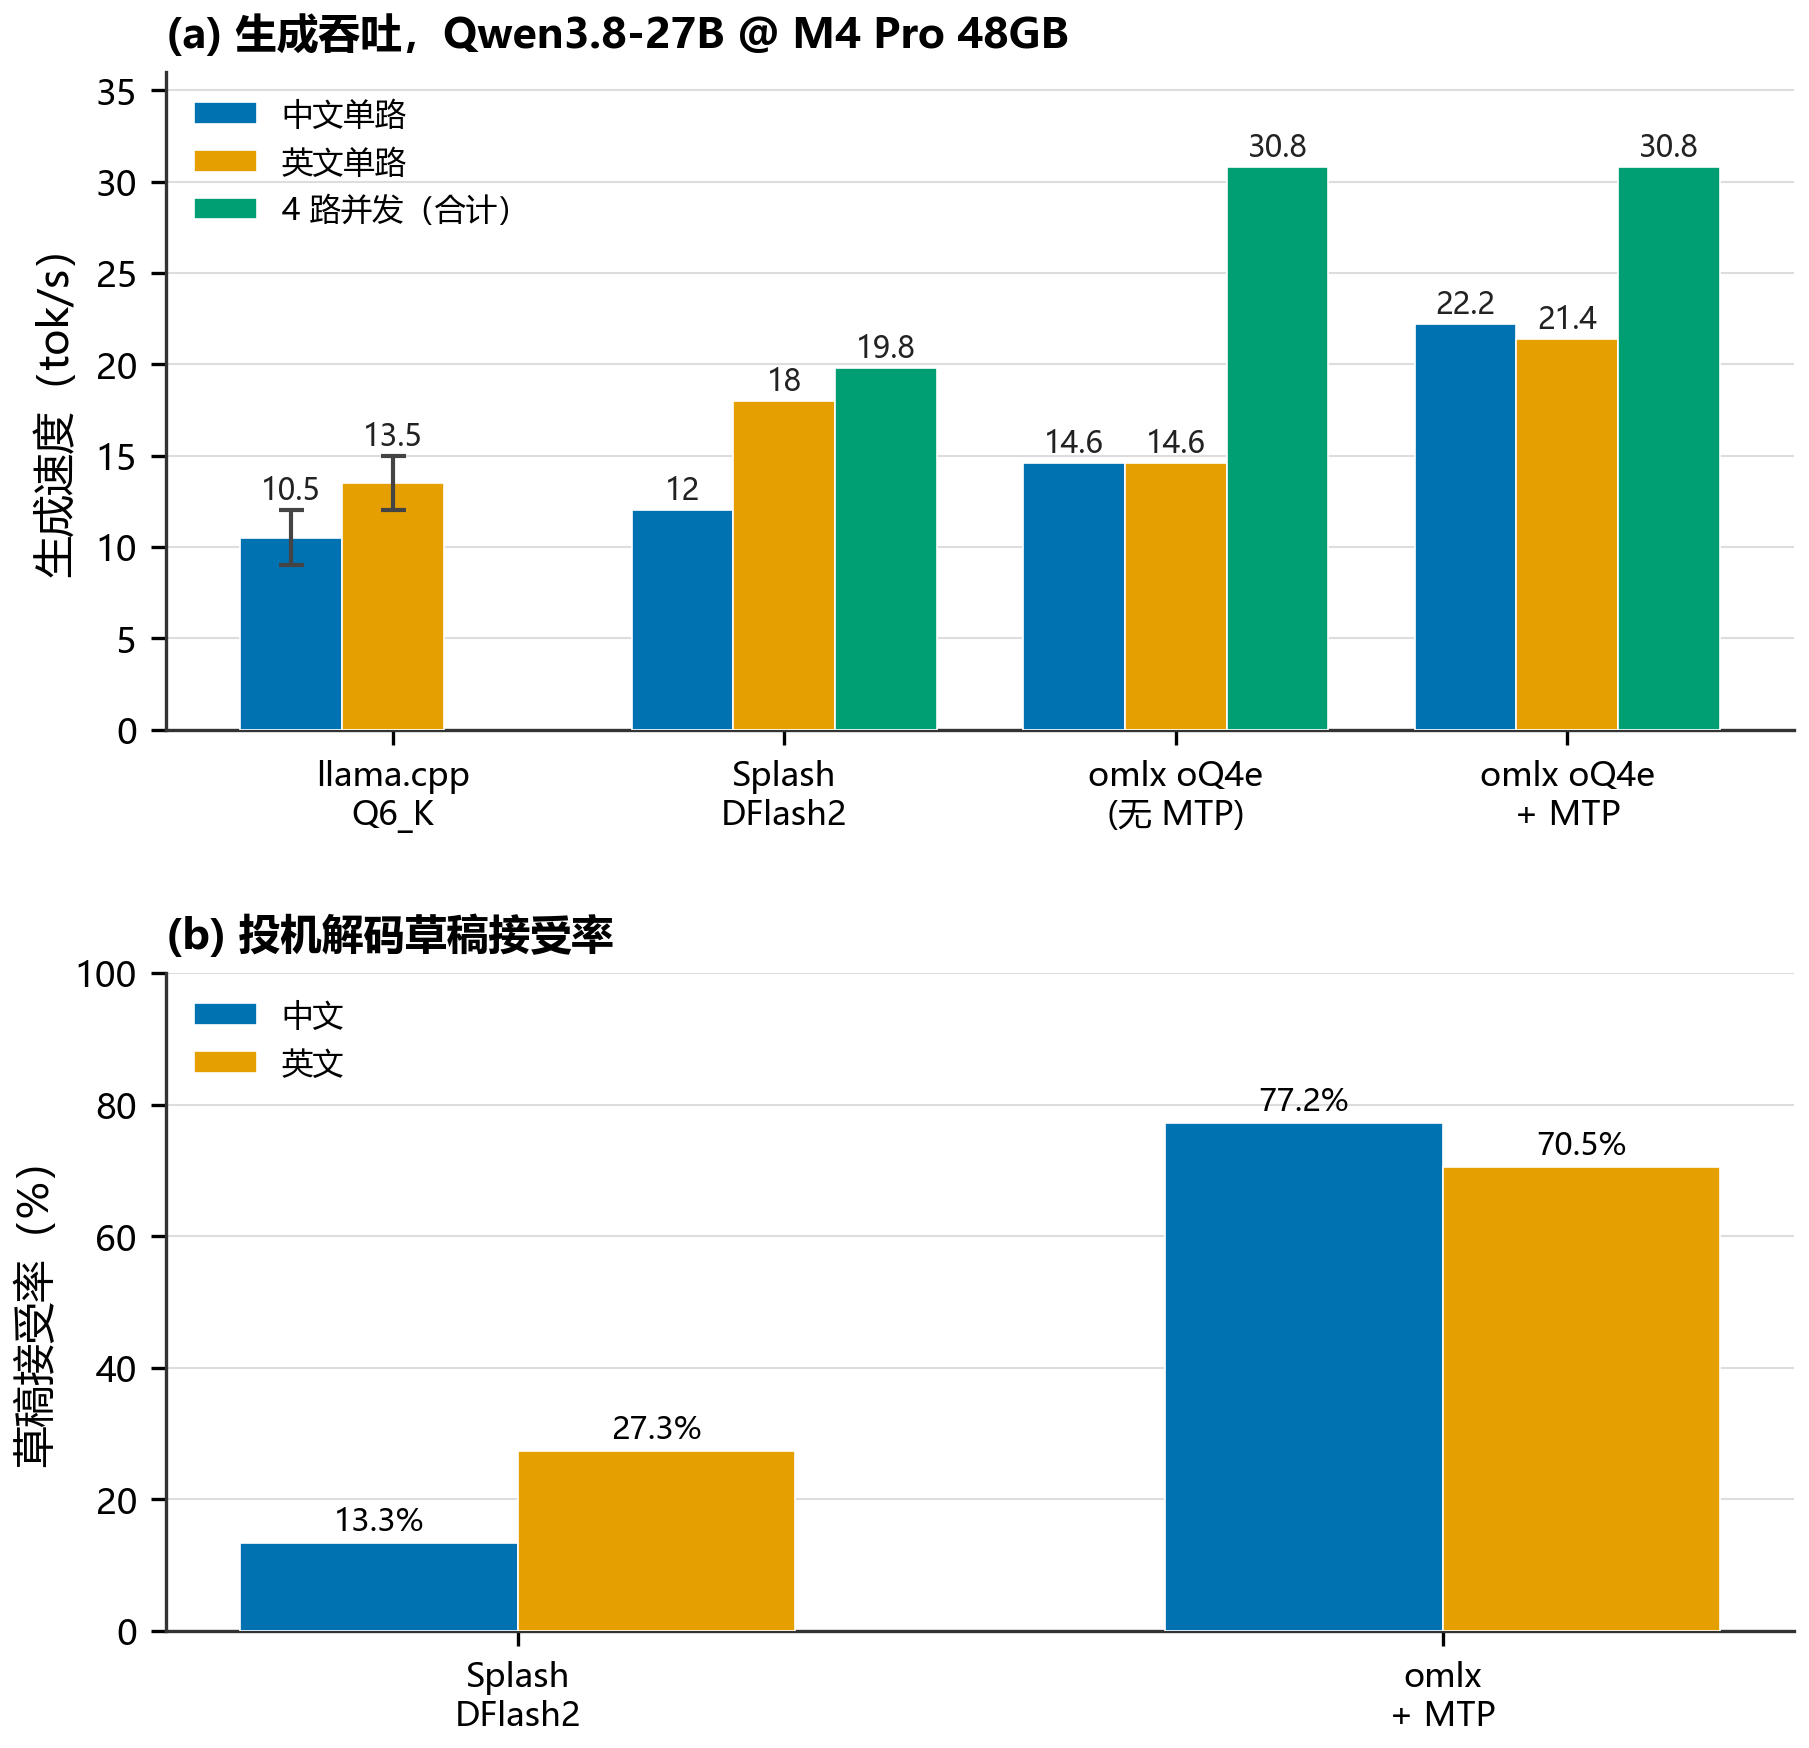
图2 Qwen3.8-27B 在 Mac mini M4 Pro 48GB 上的同口径实测。 (a) 四种引擎/配置的生成吞吐:omlx + MTP 单路约22 tok/s,约为Q6_K基线的两倍;Q6_K柱值取实测区间中点,误差线为实测区间(中文9—12、英文12—15 tok/s),Splash四并发取“重启后256K”同口径的19.8 tok/s。(b) 投机解码草稿接受率:Splash DFlash2 仅13%—27%,omlx MTP 达70%—77%——接受率决定了投机解码是真加速还是白忙。
这台Mac后来就留着做LLM节点。几套模型互斥常驻,PC通过Tailscale远程调用。要速度时跑Q4和MTP,要质量时再换Q6。
本来我也想让它兼做视频。
没成。
视频这边用的是ComfyUI。
ComfyUI本身不是模型,是个工作台——生成式AI的工作台。模型、编码器、VAE、采样器、输入输出,都做成节点,用线连起来。东西一多,看上去颇像一张电气图。
我要跑的是LTX-2.5,一个22B的视频模型。官方的LTX-2.5包括22B DiT和配套的视频、音频组件,主版本还要配合Gemma 4 12B文本编码器。官方明确支持自托管。
我实际使用的是蒸馏INT8版本。DiT大约21.5GB,Gemma4-12B文本编码器INT8约15.4GB,连其他组件在内,本地文件大约49GB。问题很明显:笔记本只有16GB显存。
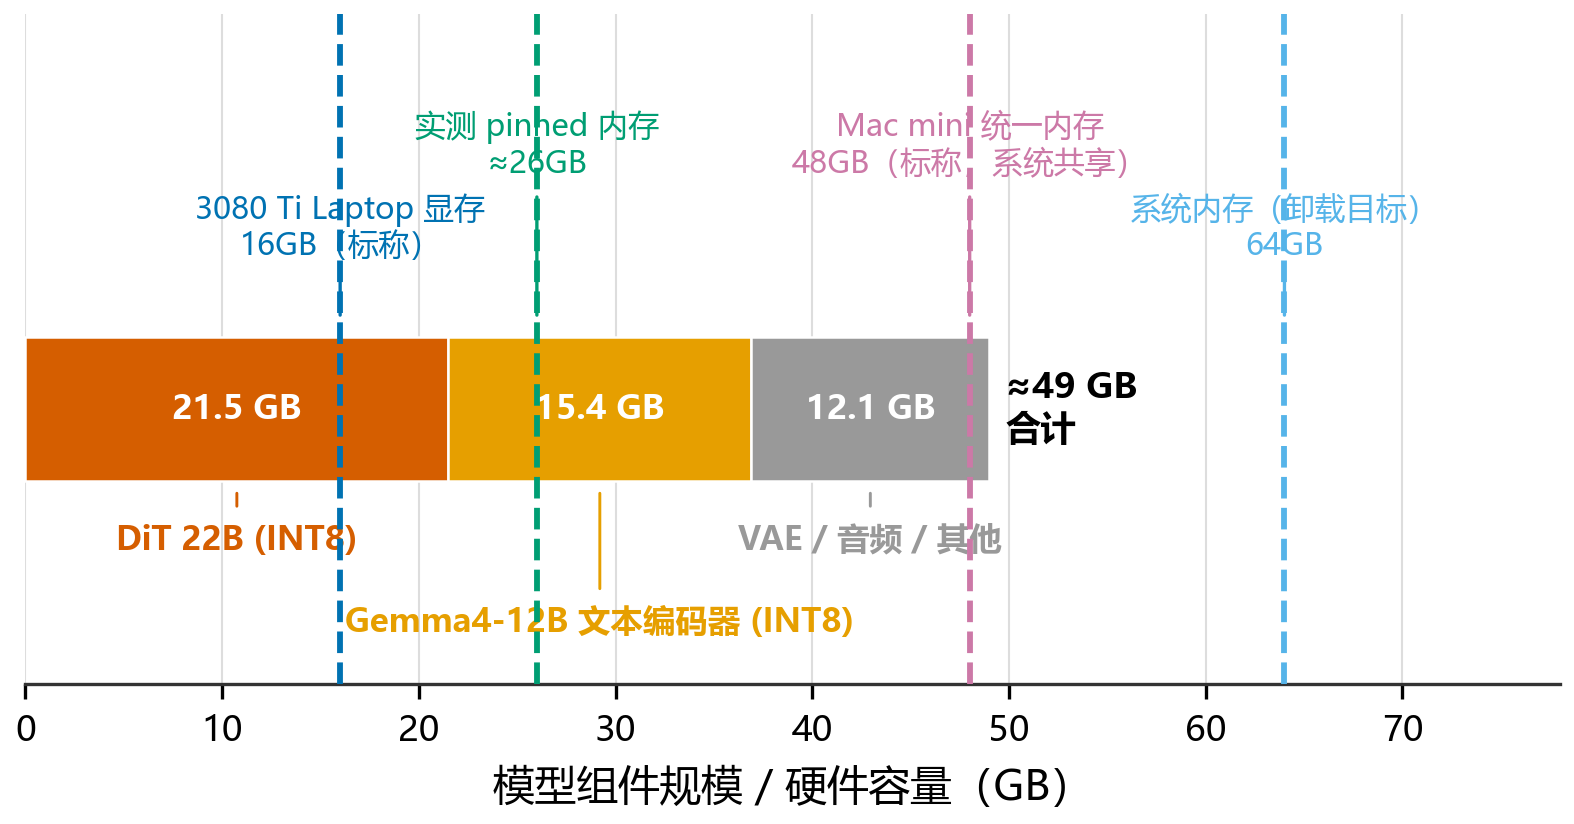
图3 LTX-2.5 INT8 模型组件规模(约49GB)与硬件标称容量的对比。 16GB显存连DiT alone都装不下,跑通的关键是ComfyUI DynamicVRAM把放不下的权重异步卸载到64GB系统内存(实测约26GB pinned memory参与)。注意49GB是模型文件量级,与运行时的实际常驻内存不是同一个概念。
但它最后跑起来了。
靠的是ComfyUI的DynamicVRAM。放不进显存的权重,被异步卸载到64GB系统内存里;实际使用中,大约有26GB pinned memory参与这件事。
反倒是48GB统一内存的Mac mini,我没有继续往下跑LTX。原因也很朴素:当时机器磁盘只剩47—52GB,连INT8整套权重都放得很勉强;更重要的是,ComfyUI-LTXVideo用到的int8 convrot加速依赖CUDA内核,MPS没有对应优化。内存数字看着大,软件栈却不是那回事。
3080 Ti Laptop于是成了视频机。
跑通之后的数据并不神奇,却很真实。960×544、2秒、49帧并带声音,第一次冒烟测试用了289秒;同分辨率的5秒片段,大约3分钟;11秒片段,大约4.7—5.9分钟。后来做1152×640、6秒的教学视频,批量平均一条约6.2分钟。
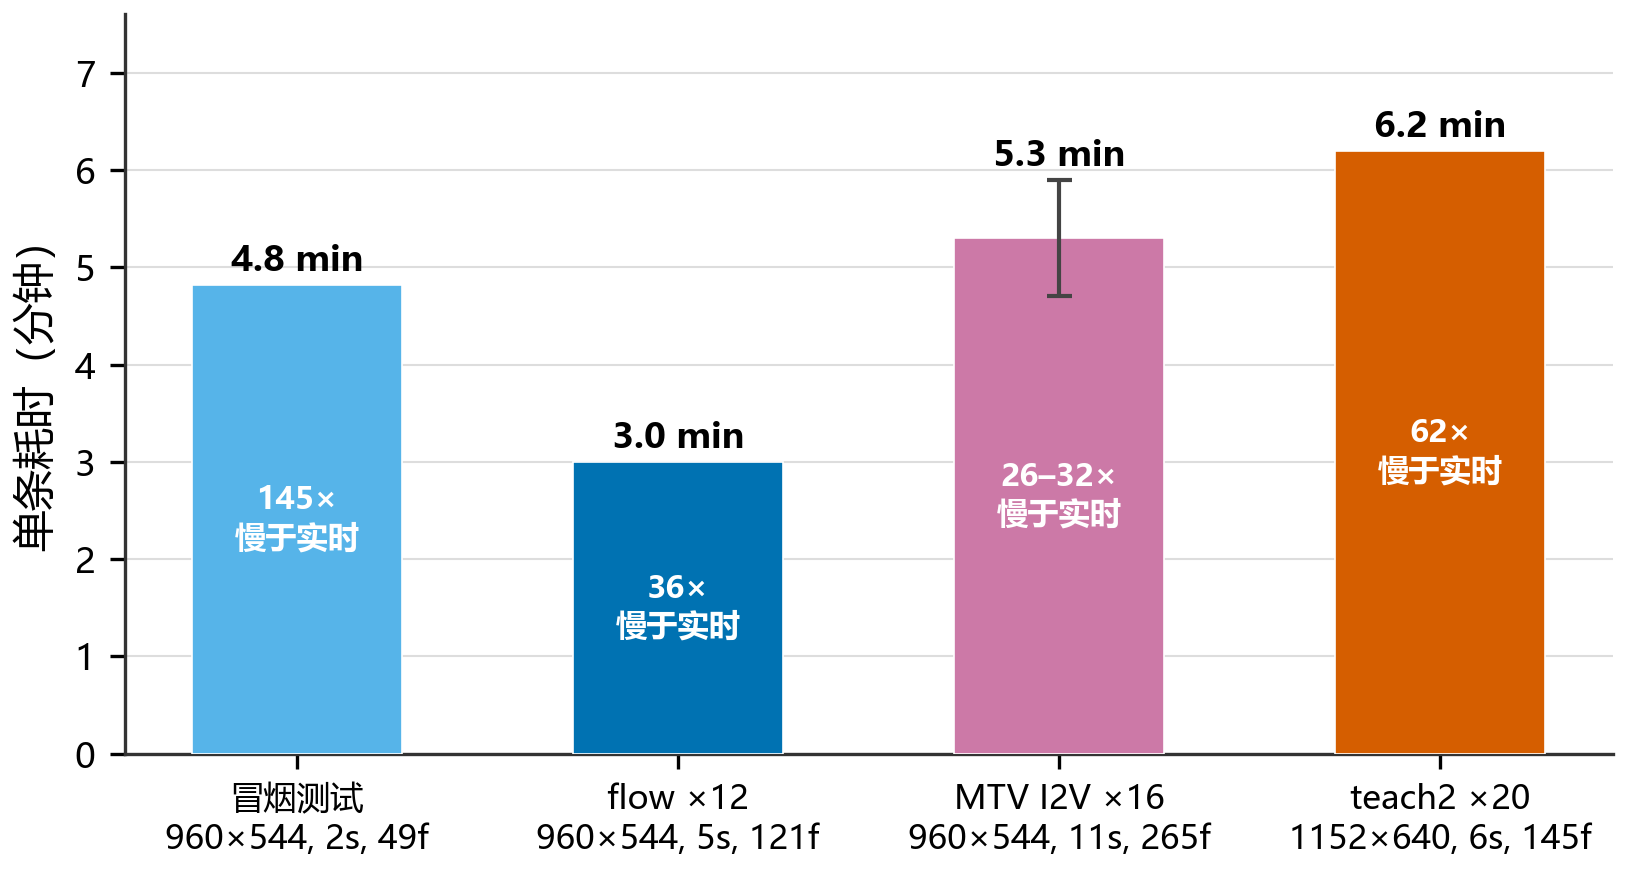
图4 LTX-2.5 22B(INT8)在 RTX 3080 Ti Laptop 上的各批次实测耗时。 MTV批次柱值取实测区间中点,误差线为实测区间(4.7—5.9分钟)。折算约26—145倍慢于实时——“能跑”和“能批量生产”是两回事。
质量是够的。
产能却不够。
真正批量做片子时,还会有废片。腿多了一条,印章穿过去了,动作不对,就得重新来。28个场景算下来,光纯生成就要三个小时以上,还没算抽帧检查和返工。最后这批教学视频还是转去了云端的Seedance 2.0,本地LTX留作离线和兜底。
这件事我倒觉得挺有意思——本地跑通了,并不等于什么都该留在本地。
回头再看,两台机器的分工最后差不多是这样的:
| 机器 | 最后适合干什么 | 实际结果 |
|---|---|---|
| Mac mini M4 Pro 48GB | LLM、Agent、并发推理 | Qwen3.8-27B Q4+MTP约21—22 tok/s;四路并发30.8 tok/s |
| RTX 3080 Ti Laptop 16GB + 64GB RAM | ComfyUI、LTX视频生成 | 22B LTX-2.5 INT8能跑;6秒1152×640约6.2分钟 |
| 云端视频模型 | 批量生产 | 本地质量够但产能不足后,生产任务转云端 |
这里面没有哪个平台赢了。
Mac统一内存大,对LLM很好;到了这套视频工作流,没有CUDA内核就吃亏。3080 Ti显存只有16GB,按权重大小根本放不下LTX-2.5,却因为CUDA、ComfyUI和DynamicVRAM这一整套东西,硬是把它跑起来。
所以现在再看到“24GB显存能跑什么”“48GB内存够不够”这类问题,我自己也很少只看一个数字了。模型是一层,量化是一层,引擎是一层,GPU内核又是一层;再往后,还有磁盘、内存带宽、offload、batch、上下文长度,甚至某个软件版本有没有把一个开关默认打开。这些东西平时不大上发布会,机器真的跑起来,却一个都躲不掉。
这样再回到最开始那个有点外行的问题:“有没有全方位的大模型?”
好像也有了另一个答案。
确实有模型正在往“什么都会”走。Qwen3-Omni这一类就是。只是实际把AI装进自己的机器以后,很容易长成另一种样子:Qwen负责读写和推理,PaddleOCR负责文档,Embedding负责找资料,Laya也许负责大量快速判断,ComfyUI带着LTX去做视频,碰到批量生产再把任务送去云端。
这不是一个模型,也不像一台超级计算机,倒更像一个小办公室。桌边那台Mac负责看材料、想事情,旁边的Windows机器擅长干CUDA的活,小模型跑得快,守着门口分分类,视频活太多的时候,就发出去加工。
机器都不算顶级,各有各的脾气,凑在一起,事情倒也能做。
所谓“全方位”,最后未必是有一个模型什么都会。
也可能只是这些东西彼此知道,该把活交给谁。
模型参数、许可证及官方部署要求主要核对各项目官方GitHub仓库与Hugging Face模型卡;Qwen3.8-27B与LTX-2.5的性能数据为作者在本文所述硬件上的实测结果,不代表其他硬件与软件版本。