研究 · 2026 年 9 月
把 AI 装进自己的电脑
从 Qwen、Jev、Laya 到 ComfyUI,再到两台普通机器上的实测
2026-09
本地能跑的大模型都有些什么?语言、推理、图片、视频,是不是都有?我们把 2026 年 9 月有代表性的本地模型摊在桌上,再在两台普通机器——一台 48GB 统一内存的 Mac mini,一台 16GB 显存的 RTX 3080 Ti 笔记本——上真装真跑,记下数字,也记下坑。
三个要点
模型大小和重要性没有简单关系
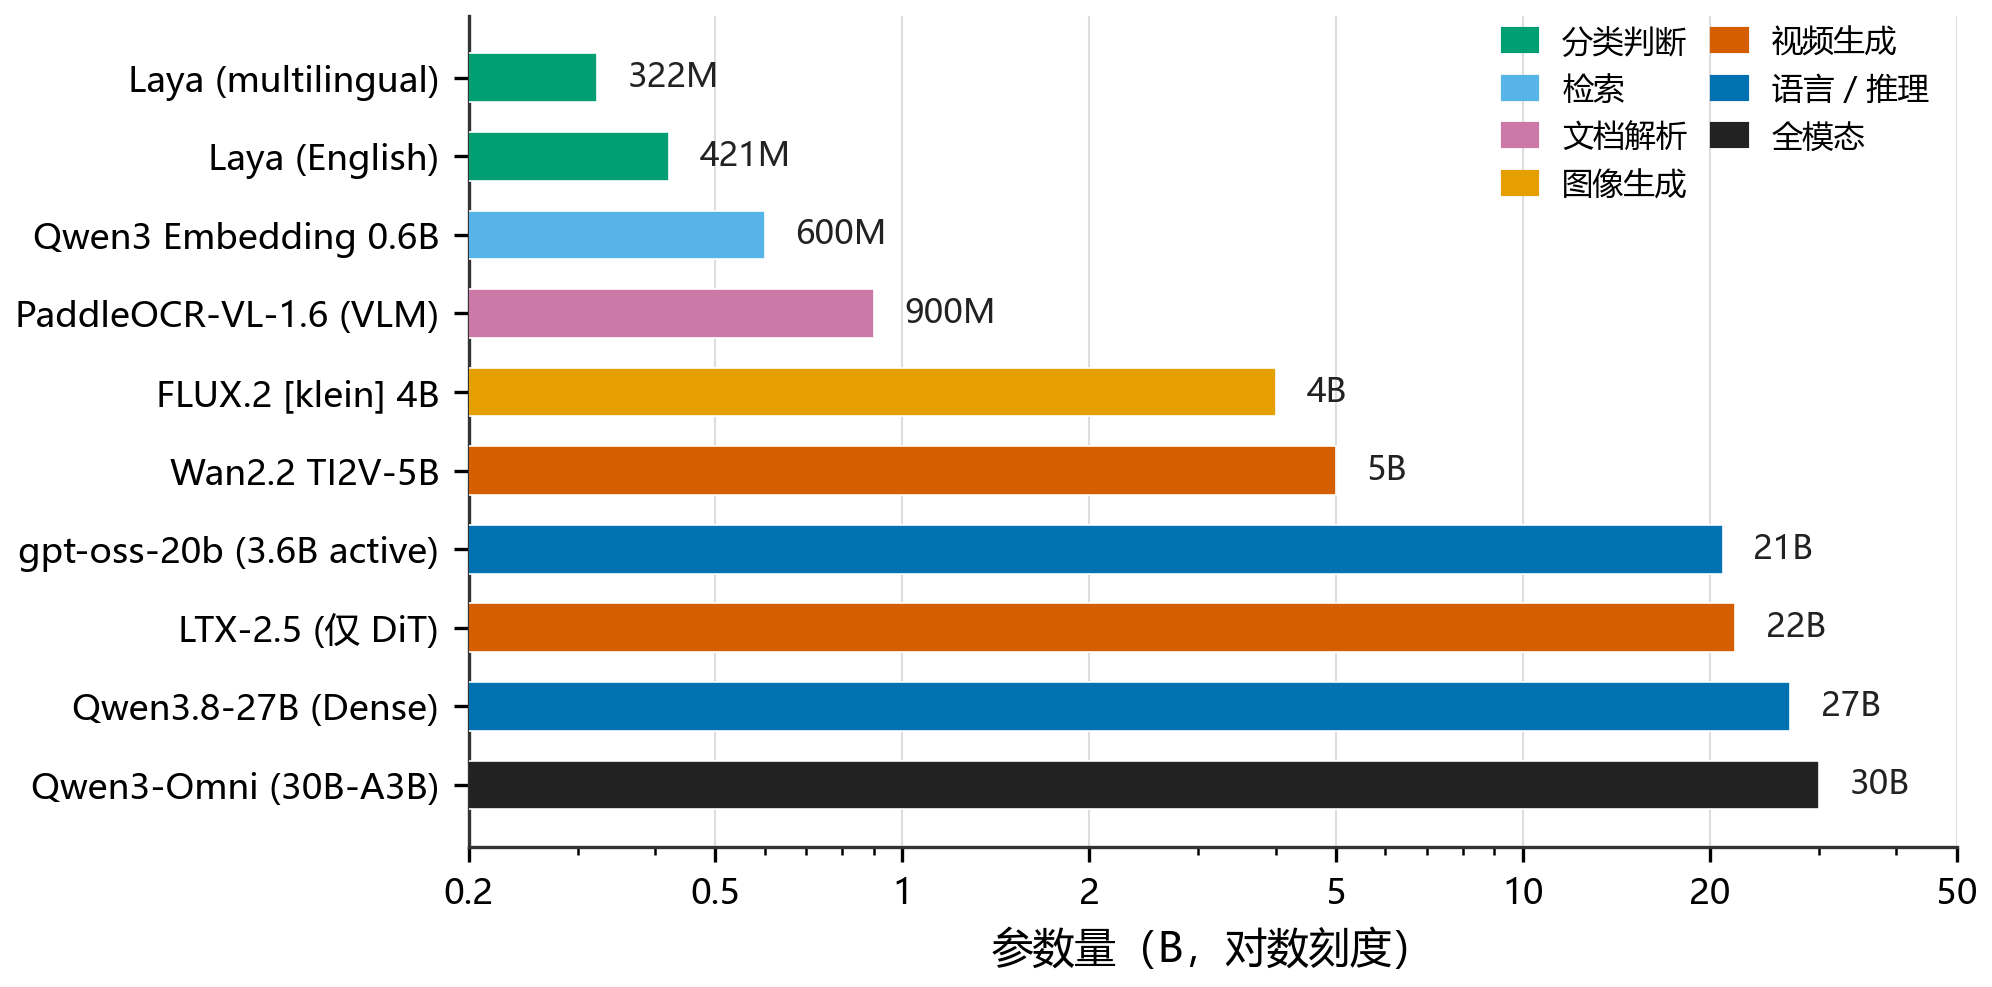
从 322M 的分类模型到 30B 的全模态模型,跨度接近两个数量级。提取合同里的表格和印章,0.9B 的专用模型就够;而一段六秒的视频,能让一张高端显卡忙上好几分钟。AI 慢慢有了工具箱的样子。
16GB 显存,反而把 22B 视频模型跑起来了
48GB 统一内存的 Mac 跑 LLM 很好,却跑不动这套视频工作流——int8 加速依赖 CUDA 内核,MPS 没有对应优化。16GB 显存的 3080 Ti 笔记本靠着 ComfyUI DynamicVRAM 把放不下的权重卸载到 64GB 系统内存,硬是把 22B 的 LTX-2.5 跑通:6 秒 1152×640 视频约 6.2 分钟一条。
「全方位」是分工,不是一个模型什么都会
同一台机器、同一个 27B 模型,换量化、引擎和解码方式,速度翻了约一倍(omlx + MTP 达 22.2 token/s)。本地跑通不等于什么都该留在本地:批量生产最终转向云端。所谓全方位,最后可能只是这些东西彼此知道,该把活交给谁。