septembre 2026
Sous appariement contrôlé, la révision des paires les plus distantes ne bat pas l'appariement aléatoire.
La distance sémantique augmente la détection d'erreur, pas la correction d'erreur.
La révision génère des réponses correctes nouvelles qui sont rarement livrées.
La synthèse sans révision bat la révision par les pairs sur le benchmark le plus difficile.
Le Beneficial Transition Ratio (taux de transitions bénéfiques) quantifie l'effet net nul de la révision.
Mots-clés : systèmes multi-agents ; grands modèles de langue ; calcul au moment du test ; topologie de communication ; révision par les pairs ; résultat négatif
Répéter l'inférence stochastique d'un modèle de langue fixe peut améliorer sensiblement l'exactitude des réponses sans toucher aux poids du modèle : le vote d'auto-cohérence sur des échantillons indépendants [1] et le passage à l'échelle par échantillonnage-vote [4] en sont les exemples canoniques. Une étape naturelle consiste à faire communiquer les instances échantillonnées : le débat multi-agents [2] et les schémas de révision par les pairs [25] permettent aux instances d'un modèle de critiquer leurs réponses respectives avant l'agrégation.
La communication entre agents homogènes présente pourtant une faiblesse structurelle. Les instances d'un même checkpoint, recevant la même invite, ne se trompent pas indépendamment : elles partagent données d'entraînement, biais inductifs et modes d'échec, de sorte que leurs échantillons forment des clusters de raisonnement corrélés — des groupes de réponses qui partagent hypothèses, stratégies et idées fausses. La communication de type diffusion tend alors à renforcer le point de vue majoritaire, qui est précisément celui le plus susceptible d'incarner l'erreur partagée. Empiriquement, le débat ne parvient souvent pas à battre le simple vote [6, 7], et les variantes sensibles à la diversité qui élaguent ou retiennent les messages communiquent toujours par diffusion [5, 10].
Cet article pose une question qui, à notre connaissance, n'a jamais été isolée expérimentalement :
Qui devrait réviser qui ? Étant données \(N\) réponses indépendantes d'un même modèle, la topologie de la révision par les pairs deux à deux — en l'occurrence, l'appariement de chaque agent avec le pair qui lui est sémantiquement le plus différent — permet-elle d'extraire davantage de réponses correctes que l'appariement aléatoire, l'appariement par similarité, le débat ou le vote, à modèle, invite et budget d'inférence identiques ?
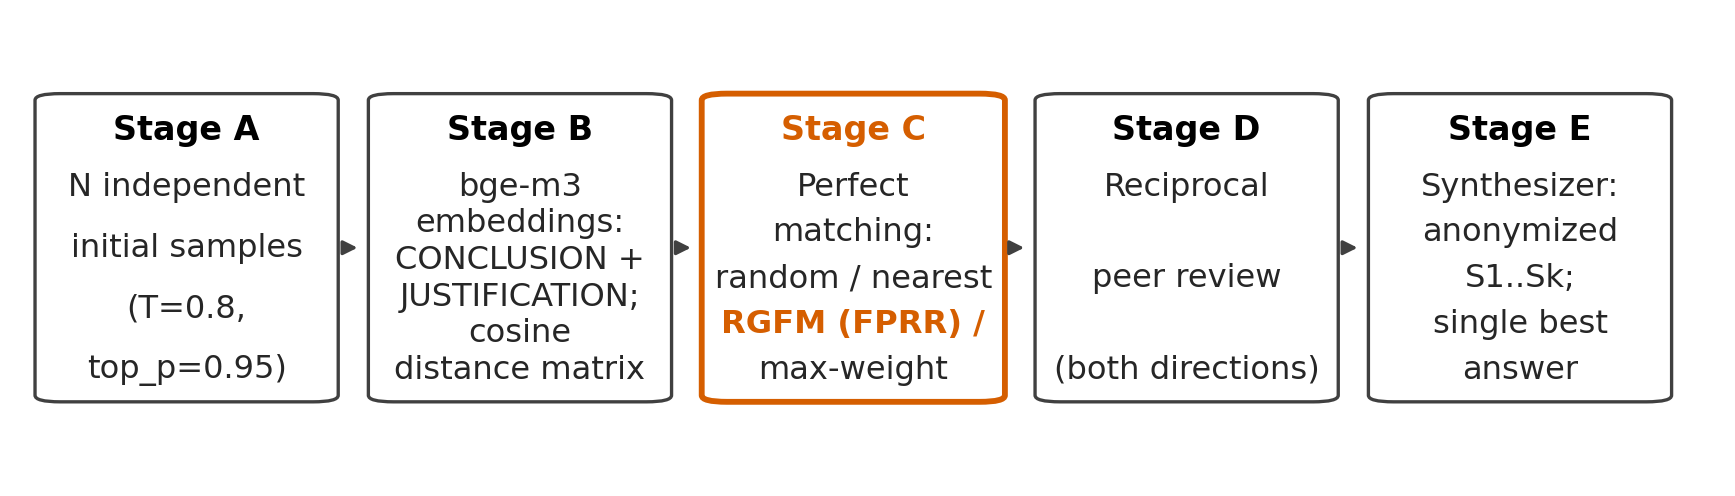
Nous concrétisons cette question sous la forme de l'évaluation réciproque des paires les plus distantes (Farthest-Pair Reciprocal Review, FPRR) : plonger chaque réponse (conclusion + justification concise), calculer une matrice de distance cosinus deux à deux, construire un appariement parfait qui apparie les réponses distantes (un appariement glouton randomisé des plus distants, RGFM, avec un appariement exact de poids maximal comme variante), exécuter une évaluation réciproque limitée à la paire au sein de chaque paire, puis synthétiser une réponse finale à partir de toutes les réponses et révisions. Le pipeline ne requiert ni entraînement ni recherche documentaire, et utilise un seul modèle gelé et un seul jeu d'invites gelé du début à la fin.
Point crucial, notre protocole isole la contribution causale de la règle de routage : toutes les conditions d'appariement consomment exactement les mêmes réponses initiales mises en cache, de sorte que les différences ne peuvent être attribuées à la chance du rééchantillonnage ; et un contrôle d'auto-révision à calcul apparié sépare les effets de la topologie du simple fait de dépenser plus d'inférence.
Nous formalisons la topologie de révision conditionnée par les réponses et fournissons la première étude contrôlée de l'évaluation réciproque disassortative (par appariement des plus distants), incluant l'appariement exact de poids maximal, l'appariement glouton randomisé, l'appariement des plus proches et l'appariement aléatoire sur des ensembles de réponses identiques.
Un résultat nul pré-enregistré avec décomposition mécanistique : sur des ensembles de réponses identiques, la révision des paires les plus distantes égale l'appariement aléatoire, l'appariement des plus proches, l'appariement exact de poids maximal, le vote majoritaire et l'auto-révision à calcul apparié à \(\pm 1\) point de pourcentage près sur les deux benchmarks, tandis que la distance de paire prédit de façon monotone la détection d'erreur mais pas la correction d'erreur.
Une analyse mécanistique de l'information qui traverse les arêtes disassortatives : régressions par étape de détection/correction/adoption, entonnoirs de révision avant vs. inverse, effets de composition des paires, Beneficial Transition Ratios fondés sur les transitions, et modes d'échec quantifiés (déstabilisation d'alternatives valides, idée fausse partagée, défaillance du juge).
Un pipeline expérimental entièrement journalisé, à réponses mises en cache (appariement à graine fixée, analyse syntaxique déterministe, statistiques bootstrap appariées), qui isole la règle de routage de la chance du rééchantillonnage et est reproductible de bout en bout.
L'auto-cohérence [1] agrège des chaînes de pensée diverses par vote majoritaire ; Li et al. [4] montrent que l'exactitude croît avec le nombre d'agents sous le seul vote (leur mesure de similarité sélectionne l'échantillon le plus similaire — la polarité opposée à la nôtre). L'élagage par similarité de plongements de pools de traces mono-agent (Slim-SC [29], SSDP [30], DeepPrune [31]) améliore l'efficacité mais ne construit aucune communication inter-agents. DIVSE [32] diversifie au niveau de l'invite. Aucune ne conditionne une topologie de communication à des distances au niveau des réponses.
Du et al. [2] ont établi le débat par diffusion entre instances homogènes ; ReConcile [3] utilise des modèles hétérogènes avec un consensus pondéré par la confiance. Les réplications contrôlées tempèrent ces affirmations : le bénéfice du débat est conditionnel et égale souvent les baselines auto-agent [6] ; le vote peut dominer le débat [7] ; et le comportement de débat des agents est lui-même discutable dans des tâches logiques contrôlées [8]. Toutes utilisent des topologies de diffusion ou fixes.
Estornell & Liu [5] calculent des plongements de réponses et des distances deux à deux, diagnostiquent des chambres d'écho et élaguent jusqu'à un sous-ensemble de diversité maximale — mais les survivants continuent de diffuser ; il n'y a ni appariement ni évaluation réciproque. DAR [10] retient un sous-ensemble en désaccord pour la diffusion via un filtre LLM (les plongements n'apparaissent que comme métrique d'évaluation). Demystifying MAD [9] initialise les pools en maximisant le nombre de réponses uniques et entraîne la confiance via GRPO. S\(^2\)-MAD [11] utilise la similarité cosinus des réponses avec la polarité opposée (en supprimant les points de vue similaires redondants). RMoA [12] effectue une sélection de type point-le-plus-éloigné des réponses comme entrées d'agrégation, et non comme partenaires de révision. Dans cette littérature, la diversité élague, pondère, retient ou initialise — elle ne construit jamais de graphe de révision un-à-un.
CortexDebate [13], le travail le plus proche du nôtre, inclut la dissimilarité cosinus des sorties dans les poids d'arêtes d'un graphe de débat épars (composite de formule de confiance, modèles hétérogènes, graphe de diffusion seuillé, vote majoritaire). DySCo [14] liste la distance cosinus de plongements de raisonnement comme l'un de cinq signaux d'arête optionnels avec critique unidirectionnelle top-\(k\). DyTopo [15] route par similarité de descripteurs de besoin/offre. MACE [16] conditionne la sélection des pairs à la diversité de n-grammes via un bandit. Les méthodes à topologie apprise (GPTSwarm [17], DyLAN [18], AgentPrune [19], G-Designer [20], MacNet [21], Graph-GRPO [22], Guided Topology Diffusion [23], Codebook Agent [24]) conditionnent sur les requêtes, les rôles ou des valeurs apprises — jamais sur les distances entre réponses courantes — et requièrent généralement un entraînement.
Xu et al. [25] implémentent l'évaluation réciproque sur un graphe complet ; PiCO [26] apparie des agents pour une évaluation mutuelle mais les apparie au hasard (en fait, notre contrôle d'appariement aléatoire) ; un schéma de tournoi [27] apparie par classement de compétence. Une revue de 141 études [28] rapporte 88.7% de topologies statiques et aucun appariement par distance de plongement dans toute sa taxonomie. L'intersection vide qu'occupe notre méthode — distance de réponse \(\rightarrow\) appariement parfait des plus distants \(\rightarrow\) évaluation réciproque limitée à la paire \(\rightarrow\) synthèse, le tout sans entraînement sur des échantillons homogènes à même invite — est documentée dans notre rapport de filtre de nouveauté (NOVELTY_GATE.md), qui a examiné plus de 40 articles avec lecture intégrale des sections de méthode et boule de neige citationnelle sur 2,235 articles citant [2].
Pour chaque problème \(x\), \(N\) agents homogènes (en nombre pair) — même checkpoint, même invite système, même texte de problème et même configuration de décodage — produisent indépendamment des réponses \(r_i = (\text{answer}_i, \text{justification}_i)\), \(i=1,\dots,N\), où la justification est un résumé de raisonnement visible et concis (aucune chaîne de pensée cachée n'est demandée ni utilisée). L'échantillonnage stochastique indépendant est la seule source de diversité.
Chaque réponse est plongée sous la forme \(e_i = f(\text{CONCLUSION: answer}_i \mathbin{\Vert} \text{JUSTIFICATION: justification}_i)\) avec un encodeur de phrases épinglé \(f\) (bge-m3, 1024-d, digest Ollama 790764642607). Le texte de la question n'est jamais plongé, car un texte de question identique dominerait la similarité. La distance principale est la distance cosinus \(d_{ij} = 1 - \cos(e_i, e_j)\) (métrique D1). Ablations : D2 (plongements de la justification seule), D3 (hybride \(\lambda d_{ij} + (1-\lambda)\mathbf{1}[a_i \neq a_j]\), \(\lambda\) réglé sur le pilote uniquement), D4 (probabilité de contradiction NLI (inférence en langage naturel) symétrisée, roberta-large-mnli).
matrice de distance \(d \in \mathbb{R}^{N\times N}\), PRNG à graine fixée \(U \gets \{1,\dots,N\}\) ; \(M \gets \emptyset\) tirer \(i\) uniformément dans \(U\) (à graine fixée) \(j \gets \arg\max_{k \in U \setminus \{i\}} d_{ik}\) \(M \gets M \cup \{(i,j)\}\) ; \(U \gets U \setminus \{i,j\}\) appariement parfait \(M\)
FPRR utilise RGFM (Algorithme [alg:rgfm]) ; la graine est consignée car la règle gloutonne dépend de l'ordre. Contrôles : Random (appariement parfait aléatoire à graine fixée), Nearest (même boucle avec \(\arg\min\)) et MaxWeight (appariement parfait exact de poids maximal \(M^* = \arg\max_M \sum_{(i,j)\in M} d_{ij}\) par énumération exhaustive des \((N-1)!!\) appariements ; \(N \le 8\)).
Pour chaque paire \((i,j) \in M\), l'agent \(i\) révise \(j\) et \(j\) révise \(i\). Le réviseur voit le problème, sa propre réponse et justification, et la réponse et la justification du partenaire — rien d'autre : ni les réponses des autres agents, ni la vérité terrain, ni les distances de plongement, ni aucune indication sur la formation de la paire. L'invite de révision (gelée, identique pour toutes les conditions d'appariement) exige que le réviseur vérifie le pair indépendamment, liste les affirmations correctes, les erreurs spécifiques et les hypothèses non vérifiées, et conclue par un verdict (PEER CORRECT/PEER INCORRECT) et une réponse propre mise à jour. La formulation interdit explicitement de présumer qu'un côté ou l'autre a raison, afin de contrer à la fois la flagornerie et le désaccord réflexe.
Un appel au synthétiseur (même modèle) reçoit le problème, toutes les réponses candidates anonymisées (étiquettes S1…SN après un brassage à graine fixée par question) et — pour les conditions de révision — toutes les révisions deux à deux. Il ne voit jamais la vérité terrain, les noms de condition, les distances ou les informations d'appariement. Ses instructions : ne pas compter les affirmations répétées comme des preuves indépendantes ; évaluer la qualité des arguments ; utiliser les critiques pour localiser les erreurs ; récupérer les solutions minoritaires correctes lorsque c'est justifié ; ignorer la confiance rhétorique. La même invite de synthétiseur est utilisée dans toutes les conditions de révision.
Par question, FPRR coûte \(N\) générations initiales \(+\) \(N\) appels de révision \(+\) \(1\) appel de synthèse. Le contrôle à calcul apparié (C9) dépense un budget identique en \(N\) auto-révisions \(+\) \(1\) synthèse sur les mêmes réponses initiales mises en cache.
Tous les agents et le synthétiseur utilisent un seul modèle servi et gelé : deepseek-flash (DeepSeek-V4.1-Flash) via l'API DeepSeek, température \(0.8\), top-\(p\) \(0.95\), tokens max 1500 (résolution/révision) / 2500 (synthèse), mode de réflexion désactivé afin que la justification visible soit le seul artefact de raisonnement ; le fournisseur n'expose aucun paramètre de graine. La stochasticité a été vérifiée empiriquement (sorties distinctes sur des appels identiques répétés). Le modèle est homogène pour tous les agents et toutes les conditions ; aucun poids n'est modifié.
MMLU-Pro [35] (test, 12,032 éléments, CC-BY-4.0) et SuperGPQA [36] (26,526 éléments, ODC-BY ; échantillonné) comme benchmarks principaux ; GSM8K [37] (test) comme vérification de bon sens (pilote : 95% en mono-agent \(\Rightarrow\) saturé au plafond, exclu des runs complets) ; MATH-500 réservé. GPQA-Diamond et LiveBench étaient inaccessibles depuis cet environnement (accès restreint) ; SuperGPQA sert de benchmark récent de niveau troisième cycle. Les identifiants de questions sont fixés par un échantillonneur stratifié (graine d'échantillonnage 42) et partagés entre toutes les conditions et graines.
C0 réponse unique ; C1 vote majoritaire sur \(N{=}4\) réponses mises en cache ; C2 réponses mises en cache \(\rightarrow\) synthétiseur (sans révision) ; C3/C4/C5/C6 = évaluation réciproque sous appariements Random / Nearest / RGFM / MaxWeight sur les mêmes réponses mises en cache ; C9 auto-révision à calcul apparié ; C7 débat par diffusion en un tour (pilote uniquement). Toutes les conditions d'appariement consomment des réponses initiales identiques par (question, graine).
Pilote : 100 questions par benchmark. Complet : MMLU-Pro 500 questions \(\times\) 3 graines expérimentales ; SuperGPQA 500 \(\times\) 4 graines. L'ablation de métrique de distance (C5 sous D2/D3/D4, sous-ensembles de 200 questions, graine 0, D3/D4 réutilisant les réponses initiales mises en cache de D2 au sein de chaque benchmark) a été exécutée en entier sauf MMLU-Pro D4 ; l'ablation \(N \in \{2,4,6,8\}\) et l'étude de variance de graine d'appariement (pré-enregistrée, Amendement 8) n'ont pas été exécutées pour des raisons de budget (§10).
Exactitude de la réponse exacte avec un analyseur déterministe gelé (dernière ligne FINAL ANSWER: ; non analysé \(\Rightarrow\) incorrect). Bootstrap apparié (10,000 rééchantillonnages sur les questions) pour les IC (intervalles de confiance) à 95% des différences d'exactitude ; tests de McNemar avec correction de continuité pour C5 vs. {C3, C4, C1, C9} avec correction de Holm–Bonferroni. Les hypothèses H1–H6 ont été pré-enregistrées (voir preregistration.md, y compris tous les amendements) avant toute évaluation sur le test complet.
GSM8K et MATH sont anciens et fortement exposés ; nous ne fondons donc aucune affirmation sur eux. MMLU-Pro (juin 2024) et surtout SuperGPQA (janvier 2025) sont postérieurs à une grande partie des données d'entraînement ; les éléments de niveau troisième cycle de SuperGPQA et l'exactitude médiane du modèle (61% en mono-agent au pilote) en font l'instrument le plus sensible. Nous traitons néanmoins la contamination résiduelle comme une limite : elle ne peut que gonfler les nombres absolus, et s'applique identiquement à chaque condition, de sorte que les différences appariées restent interprétables.
Chaque appel API est journalisé en JSONL (identifiant de question, invite complète, sortie brute, champs analysés, usage de tokens, latence, horodatage, condition, graines). Les réponses initiales sont mises en cache et partagées entre conditions ; les décisions d'appariement ne dépendent que des distances, jamais des étiquettes de référence. Le code et les configurations sont versionnés (git) ; les scripts d'analyse sont déterministes (bootstrap à graine fixée).
La Figure 1 récapitule le pipeline (Section 3) ; dans toute cette section, toutes les conditions d'appariement consomment des réponses initiales mises en cache identiques par (question, graine).
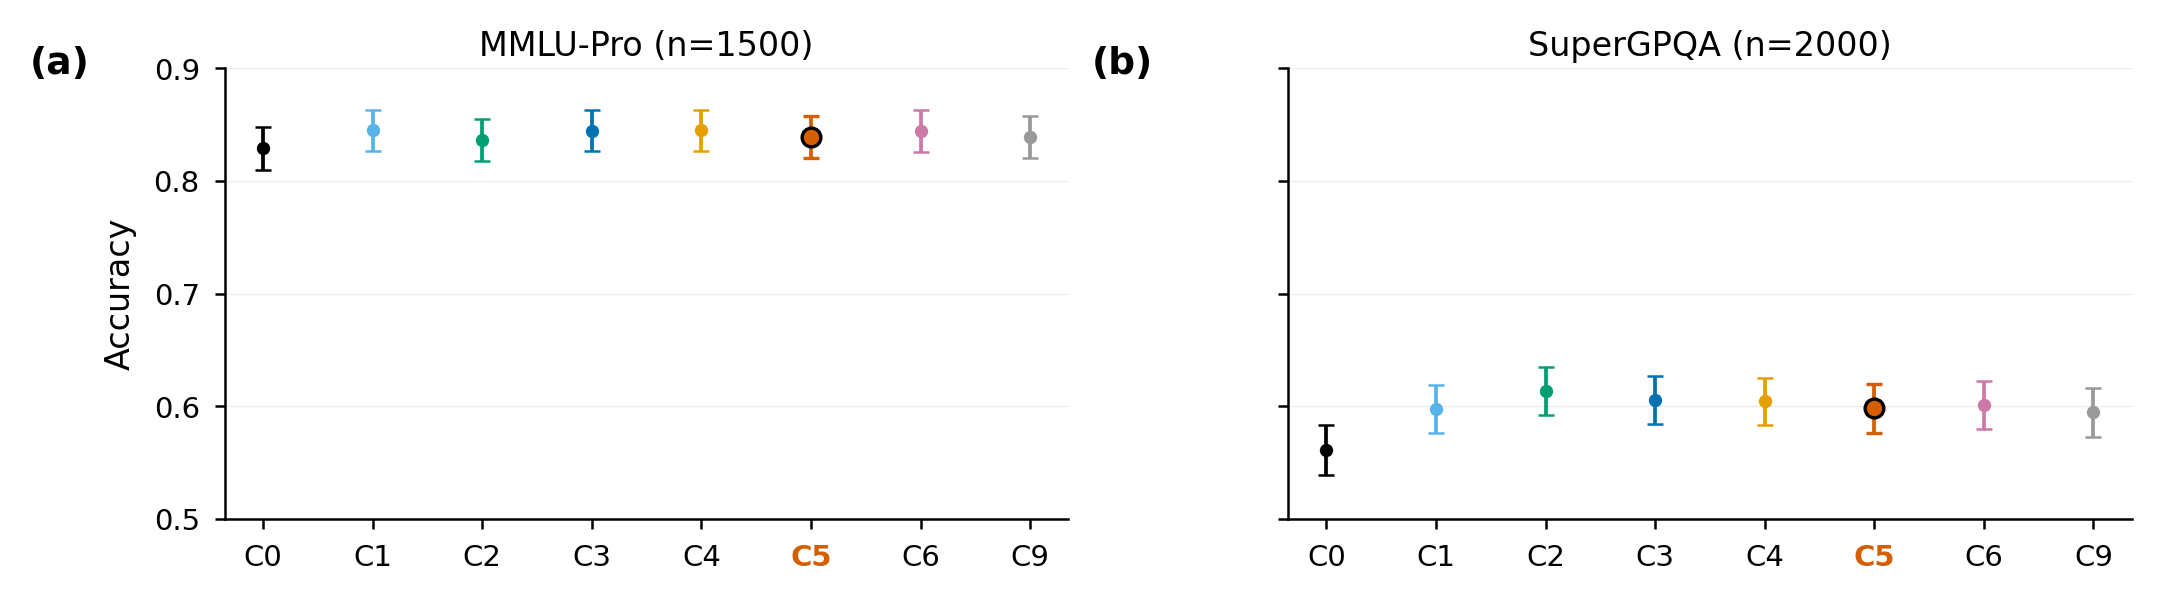
Le Tableau 1 rapporte l'exactitude sur MMLU-Pro (500 questions \(\times\) 3 graines expérimentales, \(n=1500\) observations groupées). Toutes les conditions d'agrégation \(N{=}4\) se regroupent dans une bande de 0.8pp (0.837–0.845) ; FPRR (C5, 0.839) se situe au bas de cette bande avec le contrôle d'auto-révision à calcul apparié (C9, 0.839), 0.6pp sous l'appariement aléatoire, l'appariement des plus proches, l'appariement de poids maximal et le simple vote majoritaire (tous à 0.845). La Figure 2 visualise ces exactitudes quasi identiques.
| Condition | Nom | Exactitude groupée | IC 95% | Exactitude par graine | |
| s0 / s1 | s2 | ||||
| C0 | Réponse unique | 0.829 | [0.810, 0.848] | 0.824 / 0.834 | 0.830 |
| C1 | Vote majoritaire | 0.845 | [0.827, 0.863] | 0.844 / 0.844 | 0.848 |
| C2 | Ensemble + synth. | 0.837 | [0.818, 0.855] | 0.838 / 0.840 | 0.832 |
| C3 | Paires aléatoires | 0.845 | [0.827, 0.863] | 0.846 / 0.850 | 0.838 |
| C4 | Paires les plus proches | 0.845 | [0.827, 0.863] | 0.842 / 0.846 | 0.848 |
| C5 | FPRR (RGFM) | 0.839 | [0.821, 0.857] | 0.844 / 0.836 | 0.838 |
| C6 | Appariement de poids maximal | 0.845 | [0.826, 0.863] | 0.840 / 0.846 | 0.848 |
| C9 | Auto-révision (appariée) | 0.839 | [0.821, 0.857] | 0.838 / 0.838 | 0.842 |
| Comparaison | diff (pp) | IC 95% (pp) | McNemar \(b/c\) | \(p\) | \(p_{\mathrm{Holm}}\) |
|---|---|---|---|---|---|
| C5 vs C3 (aléatoire) | \(-0.5\) | [\(-1.3\), \(0.2\)] | 13/21 | 0.230 | 0.920 |
| C5 vs C4 (plus proche) | \(-0.6\) | [\(-1.5\), \(0.3\)] | 19/28 | 0.243 | 0.920 |
| C5 vs C1 (vote) | \(-0.6\) | [\(-1.5\), \(0.3\)] | 18/27 | 0.233 | 0.920 |
| C5 vs C9 (auto-révision) | \(0.0\) | [\(-0.8\), \(0.8\)] | 19/19 | 0.871 | 0.920 |
| C5 vs C0 (unique) | \(+1.0\) | [\(-0.1\), \(2.1\)] | 41/26 | 0.087 | — |
| C5 vs C2 (sans révision) | \(+0.3\) | [\(-0.7\), \(1.2\)] | 27/23 | 0.671 | — |
| C5 vs C6 (poids maximal) | \(-0.5\) | [\(-1.4\), \(0.3\)] | 16/24 | 0.268 | — |
Le Tableau 2 donne l'analyse appariée. L'IC bootstrap de chaque comparaison principale croise zéro, et les quatre valeurs de \(p\) ajustées par Holm valent toutes \(0.920\) : il n'y a aucune différence détectable entre FPRR et l'appariement aléatoire (H1), l'appariement des plus proches (H2), le vote majoritaire (H3) ou le contrôle d'auto-révision à calcul apparié. Face à la baseline à réponse unique, FPRR gagne \(+1.0\)pp, sans atteindre la significativité (\(p=0.087\), non corrigé).
SuperGPQA (500 questions \(\times\) 4 graines, \(n=2000\) groupées) montre le même schéma à exactitude plus faible, avec un résultat plus tranché (Tableau 3). FPRR (0.599) est indiscernable de — et si tant est légèrement sous — l'appariement aléatoire (0.606), l'appariement des plus proches (0.605), l'appariement de poids maximal (0.602), le vote majoritaire (0.598) et l'auto-révision (0.595) ; les quatre valeurs de \(p\) principales ajustées par Holm sont \(\ge 0.987\) (Tableau 4). Sur ce benchmark plus difficile, chaque condition \(N{=}4\) dépasse nettement la baseline à réponse unique (C0, 0.561 ; C5 vs C0 : \(+3.8\)pp, IC 95% [\(+2.3\), \(+5.2\)], \(p<0.001\)), donc la machinerie d'ensemble aide en soi. Mais la condition synthétiseur sans révision C2 (0.614) est la meilleure condition, et ici la perte n'est plus du bruit : C2 bat C5 de \(1.5\)pp avec un IC bootstrap qui exclut zéro (\([-2.6, -0.4]\), McNemar \(p=0.010\) ; comparaison secondaire hors de la famille corrigée par Holm, et anti-conservatrice sous dépendance inter-graines). Sur le benchmark plus difficile, l'évaluation réciproque par les pairs inflige un coût net faible mais statistiquement détectable par rapport à la simple synthèse des mêmes réponses mises en cache — cohérent avec l'analyse des transitions du §7.4 (BTR \(= 0.383\)).
| Condition | Nom | Exactitude groupée | IC 95% | Exactitude par graine (s0/s1/s2/s3) |
|---|---|---|---|---|
| C0 | Réponse unique | 0.561 | [0.539, 0.583] | 0.546 / 0.572 / 0.568 / 0.558 |
| C1 | Vote majoritaire | 0.598 | [0.576, 0.619] | 0.594 / 0.604 / 0.588 / 0.604 |
| C2 | Ensemble + synth. | 0.614 | [0.593, 0.635] | 0.616 / 0.622 / 0.608 / 0.608 |
| C3 | Paires aléatoires | 0.606 | [0.584, 0.627] | 0.594 / 0.598 / 0.616 / 0.614 |
| C4 | Paires les plus proches | 0.605 | [0.583, 0.625] | 0.598 / 0.604 / 0.602 / 0.614 |
| C5 | FPRR (RGFM) | 0.599 | [0.577, 0.620] | 0.598 / 0.602 / 0.596 / 0.598 |
| C6 | Appariement de poids maximal | 0.602 | [0.580, 0.623] | 0.594 / 0.606 / 0.608 / 0.598 |
| C9 | Auto-révision (appariée) | 0.595 | [0.573, 0.616] | 0.602 / 0.586 / 0.588 / 0.604 |
| Comparaison | diff (pp) | IC 95% (pp) | McNemar \(b/c\) | \(p\) | \(p_{\mathrm{Holm}}\) |
|---|---|---|---|---|---|
| C5 vs C3 (aléatoire) | \(-0.7\) | [\(-1.8\), \(+0.4\)] | 56/70 | 0.247 | 0.987 |
| C5 vs C4 (plus proche) | \(-0.6\) | [\(-1.7\), \(+0.5\)] | 54/66 | 0.315 | 0.987 |
| C5 vs C1 (vote) | \(+0.1\) | [\(-1.1\), \(+1.3\)] | 72/70 | 0.933 | 1.000 |
| C5 vs C9 (auto-révision) | \(+0.4\) | [\(-0.8\), \(+1.5\)] | 68/61 | 0.597 | 1.000 |
| C5 vs C0 (unique) | \(+3.8\) | [\(+2.3\), \(+5.2\)] | 151/76 | \(<\)0.0001 | — |
| C5 vs C2 (sans révision) | \(-1.5\) | [\(-2.6\), \(-0.4\)] | 49/79 | 0.010 | — |
| C5 vs C6 (poids maximal) | \(-0.3\) | [\(-1.4\), \(+0.8\)] | 54/60 | 0.640 | — |
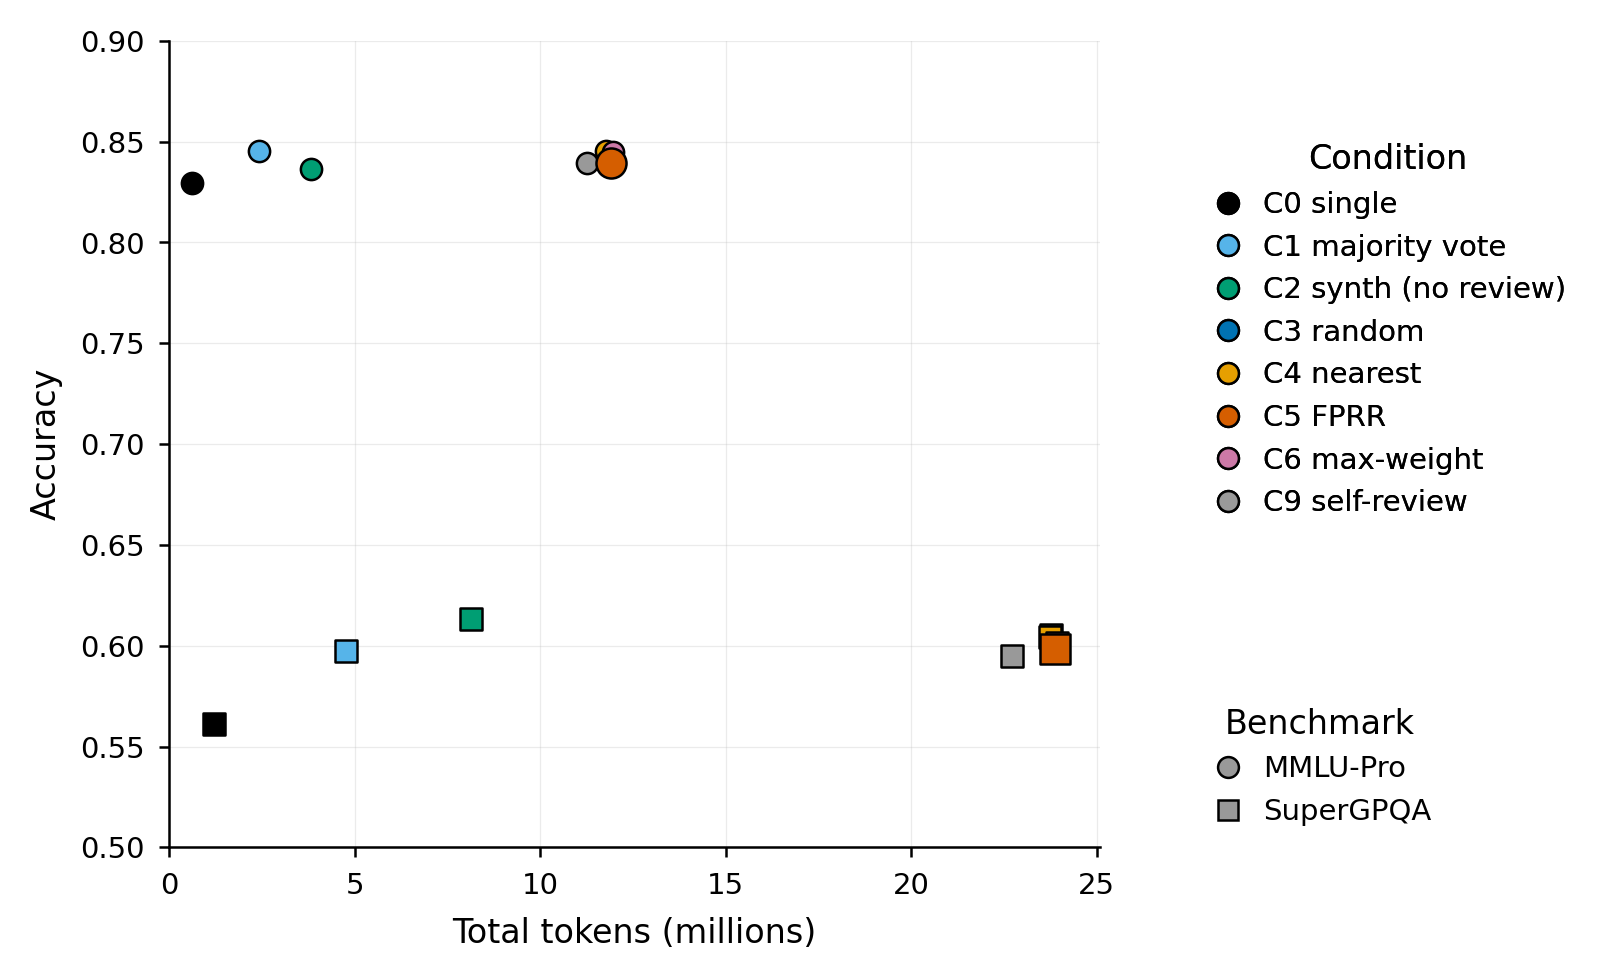
La révision est coûteuse et n'achète rien ici (Tableau 5, Figure 3). Sur MMLU-Pro, C5 consomme \(11.89\)M de tokens — \(19.7\times\) la baseline à réponse unique et \(4.9\times\) le vote majoritaire — pour 0.6pp d'exactitude de moins que le vote ; l'exactitude par million de tokens chute de 1.37 (C0) et 0.35 (C1) à 0.07 pour toutes les conditions de révision. SuperGPQA montre le même schéma à coût en tokens par graine comparable (\(23.87\)M pour C5 sur 4 graines), où la révision accuse en outre un retard significatif sur la synthèse sans révision.
| MMLU-Pro (\(n=1500\)) | SuperGPQA (\(n=2000\)) | |||
| Condition | tokens (M) | exact./Mtok | tokens (M) | exact./Mtok |
| C0 | 0.60 | 1.37 | 1.20 | 0.47 |
| C1 | 2.41 | 0.35 | 4.76 | 0.13 |
| C2 | 3.82 | 0.22 | 8.14 | 0.08 |
| C3 | 11.80 | 0.07 | 23.77 | 0.03 |
| C4 | 11.78 | 0.07 | 23.74 | 0.03 |
| C5 | 11.89 | 0.07 | 23.87 | 0.03 |
| C6 | 11.95 | 0.07 | 23.92 | 0.03 |
| C9 | 11.26 | 0.07 | 22.71 | 0.03 |
H1 (FPRR \(>\) appariement aléatoire) : non étayée. \(-0.5\)pp sur MMLU-Pro, \(-0.7\)pp sur SuperGPQA ; les deux IC croisent zéro (\(p_{\mathrm{Holm}} = 0.920\) / \(0.987\)). H2 (FPRR \(>\) appariement des plus proches) : non étayée. \(-0.6\)pp / \(-0.6\)pp (\(p_{\mathrm{Holm}} = 0.920\) / \(0.987\)). H3 (FPRR \(>\) vote majoritaire) : non étayée. \(-0.6\)pp / \(+0.1\)pp (\(p_{\mathrm{Holm}} = 0.920\) / \(1.000\)). L'appariement exact de poids maximal (C6) ne fait pas mieux que le RGFM glouton, et le contrôle d'auto-révision à calcul apparié (C9) reproduit l'exactitude de FPRR presque exactement sur les deux benchmarks ; le résultat nul n'est donc attribuable ni à une sous-optimalité de l'appariement ni au calcul de révision lui-même.
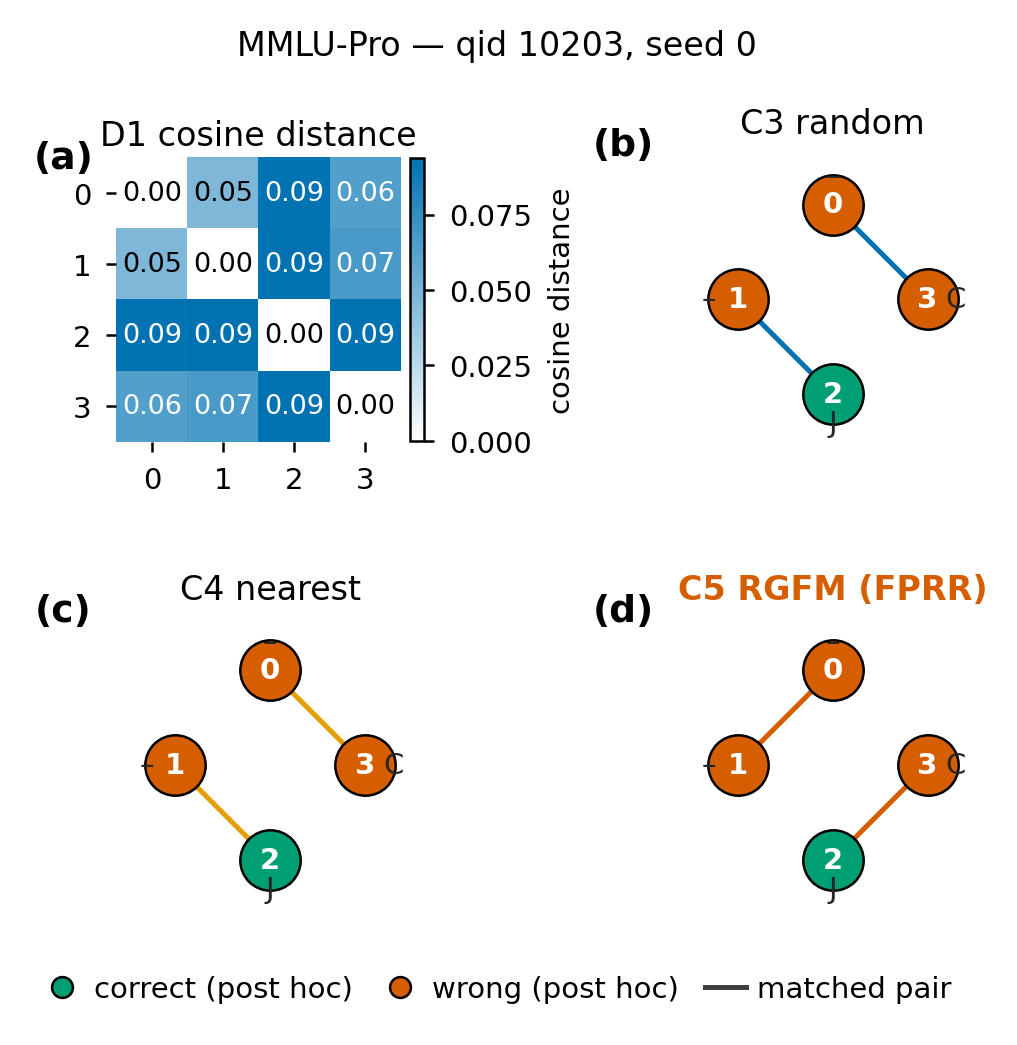
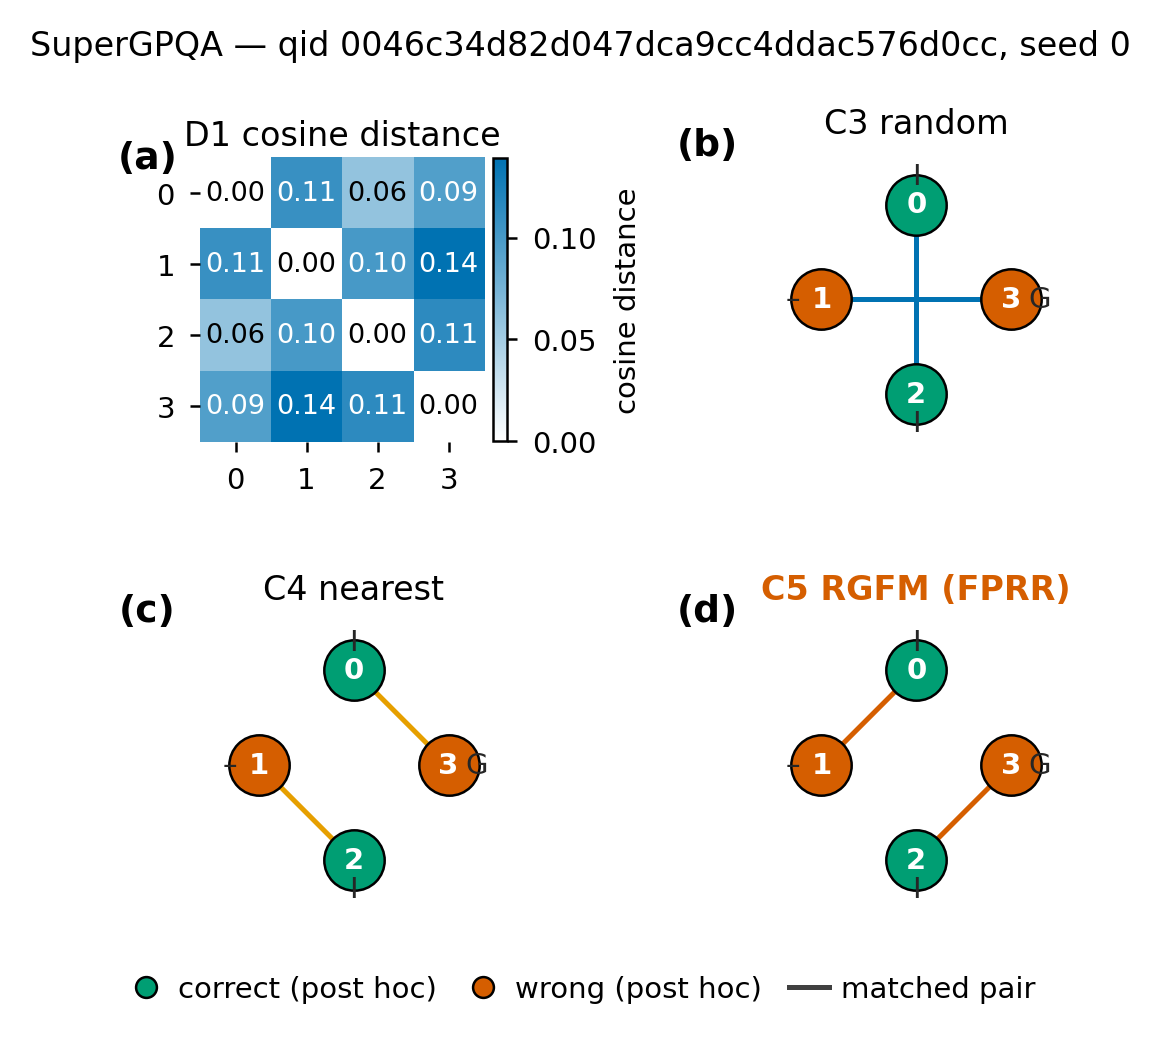
Comme les quatre conditions d'appariement révisent les mêmes réponses initiales mises en cache, toute différence d'exactitude entre elles est attribuable au seul appariement. Il n'y en a essentiellement aucune : sur MMLU-Pro, C3/C4/C5/C6 obtiennent 0.845 / 0.845 / 0.839 / 0.845 (écart 0.6pp) ; sur SuperGPQA (\(n=2000\), 4 graines) 0.606 / 0.605 / 0.599 / 0.602 (écart 0.7pp). L'appariement exact de poids maximal (C6) est indiscernable du RGFM glouton (C5), et l'appariement des plus proches (C4) — la polarité opposée — égale l'appariement aléatoire. La Figure 5 visualise combien les quatre règles câblent différemment les mêmes réponses ; le câblage ne change rien à l'exactitude.
Sur MMLU-Pro, les conditions de révision (0.839–0.845) se situent à moins de 0.8pp de la condition synthétiseur sans révision C2 (0.837), et le vote C1 (0.845) égale la meilleure condition de révision pour une fraction du coût. Sur SuperGPQA, l'ordre s'inverse : C2 (0.614) est la meilleure condition, au-dessus de toutes les conditions de révision (0.599–0.606), avec C1 à 0.598 — et avec quatre graines l'écart est statistiquement détectable (C5 vs C2 : \(-1.5\)pp, IC 95% [\(-2.6\), \(-0.4\)], \(p=0.010\) non corrigé ; Tableau 4). L'évaluation réciproque n'ajoute donc aucune valeur par rapport à l'une ou l'autre baseline d'agrégation — et sur le benchmark plus difficile elle en retranche un peu.
L'auto-révision à budget d'appels identique reproduit FPRR presque exactement (0.839 vs 0.839 sur MMLU-Pro ; 0.595 vs 0.599 sur SuperGPQA ; diff C5 vs C9 \(0.0\)pp / \(+0.4\)pp, \(p_{\mathrm{Holm}} = 0.920\) / \(1.000\)). Dépenser le budget de révision en auto-critique est exactement aussi bon — et aussi limité — que de le dépenser en révision par les pairs : le budget étant fixé, le résultat nul se rattache au routage.
Conformément à la pré-inscription, \(\lambda\) pour la distance hybride D3 a été fixé à \(0.5\) avant les runs complets, comme meilleure valeur au pilote sur le benchmark offrant le plus de marge et comme point médian sinon (ablation de distance pilote sous C5, 100 questions par benchmark, graine 0 ; les données pilotes ne servent qu'au réglage et ne sont pas rapportées comme preuve). Le Tableau 6 rapporte l'ablation de distance complète sur 200 questions (C5 sous D2/D3/D4, graine 0 ; au sein de chaque benchmark, D3/D4 réutilisent les réponses initiales mises en cache de D2, de sorte que les comparaisons appariées inter-métriques isolent la topologie induite par chaque métrique). Cette analyse est exploratoire (Amendement 8 de la pré-inscription : mécanistique, hors de la famille principale corrigée par Holm).
Sur SuperGPQA, les métriques sensibles au désaccord battent la distance sémantique pure : D4 (contradiction NLI) atteint \(0.680\) contre \(0.650\) pour D2 (cosinus conclusion+justification), et la différence appariée D4 \(-\) D2 vaut \(+3.0\)pp avec un IC bootstrap qui exclut zéro (\([+0.5, +6.0]\)) — mais sur seulement \(7\) contre \(1\) questions discordantes (McNemar \(p=0.077\)), une seule graine et 200 questions : le signal est réel mais fragile et exige une réplication. Le mécanisme est cohérent avec le §7 : sous D4, le taux de corruption de la majorité chute d'un facteur six par rapport à D2 (\(0.008\) vs \(0.048\) ; D3 : \(0.024\)) tandis que le taux de correction est le plus élevé des trois métriques (\(0.289\) vs \(0.268\) sous D2 ; les taux de verdicts d'opposition erronée au niveau révision sont plats, \(0.047\)–\(0.052\)) — la contradiction NLI se rapproche de l'opposition épistémique davantage que le cosinus de plongements, de sorte que l'appariement des plus distants sous D4 choisit des disputes qui valent plus souvent la peine. Sur MMLU-Pro, toutes les différences de métriques sont nulles (D2/D3 à moins de \(0.5\)pp l'une de l'autre et du vote) : le benchmark saturé ne laisse aucune marge à un quelconque signal de routage. MMLU-Pro D4 n'a pas été exécuté (budget).
| Benchmark | Métrique | exactitude C5 | exactitude C1 | C5 \(-\) C1 [IC 95%], \(p\) | apparié vs D2 [IC 95%], \(p\) |
|---|---|---|---|---|---|
| SuperGPQA | D2 (cosinus) | 0.650 [0.585, 0.715] | 0.630 | \(+2.0\) [\(-2.0\), \(+6.0\)], \(0.45\) | — |
| SuperGPQA | D3 \(\lambda{=}0.5\) | 0.670 [0.605, 0.735] | 0.630 | \(+4.0\) [\(+0.5\), \(+7.5\)], \(0.061\) | \(+2.0\) [\(-0.5\), \(+5.0\)], \(0.29\) |
| SuperGPQA | D4 (contr. NLI) | 0.680 [0.615, 0.745] | 0.630 | \(+5.0\) [\(+2.0\), \(+8.5\)], \(0.009\) | \(+3.0\) [\(+0.5\), \(+6.0\)], \(0.077\) (7:1) |
| MMLU-Pro | D2 (cosinus) | 0.860 [0.810, 0.905] | 0.865 | \(-0.5\) [\(-2.5\), \(+1.5\)], NS | — |
| MMLU-Pro | D3 \(\lambda{=}0.5\) | 0.865 [0.815, 0.910] | 0.865 | \(0.0\) [\(-2.5\), \(+3.0\)], NS | \(+0.5\) [\(-1.5\), \(+2.5\)], \(1.0\) |
| MMLU-Pro | D4 (contr. NLI) | non exécuté (budget) | |||
Non exécuté (budget). L'ablation \(N \in \{2,6,8\}\) et l'étude de variance de graine d'appariement (graines d'appariement 1, 2 pour C3/C5, sous-ensembles MMLU-Pro de 200 questions) ont été conçues et gelées dans la pré-inscription (Amendement 8) mais n'ont pu être exécutées dans le budget API restant ; nous les rapportons comme manquantes plutôt que de les passer sous silence, et comptons leur absence comme une limite (§10).
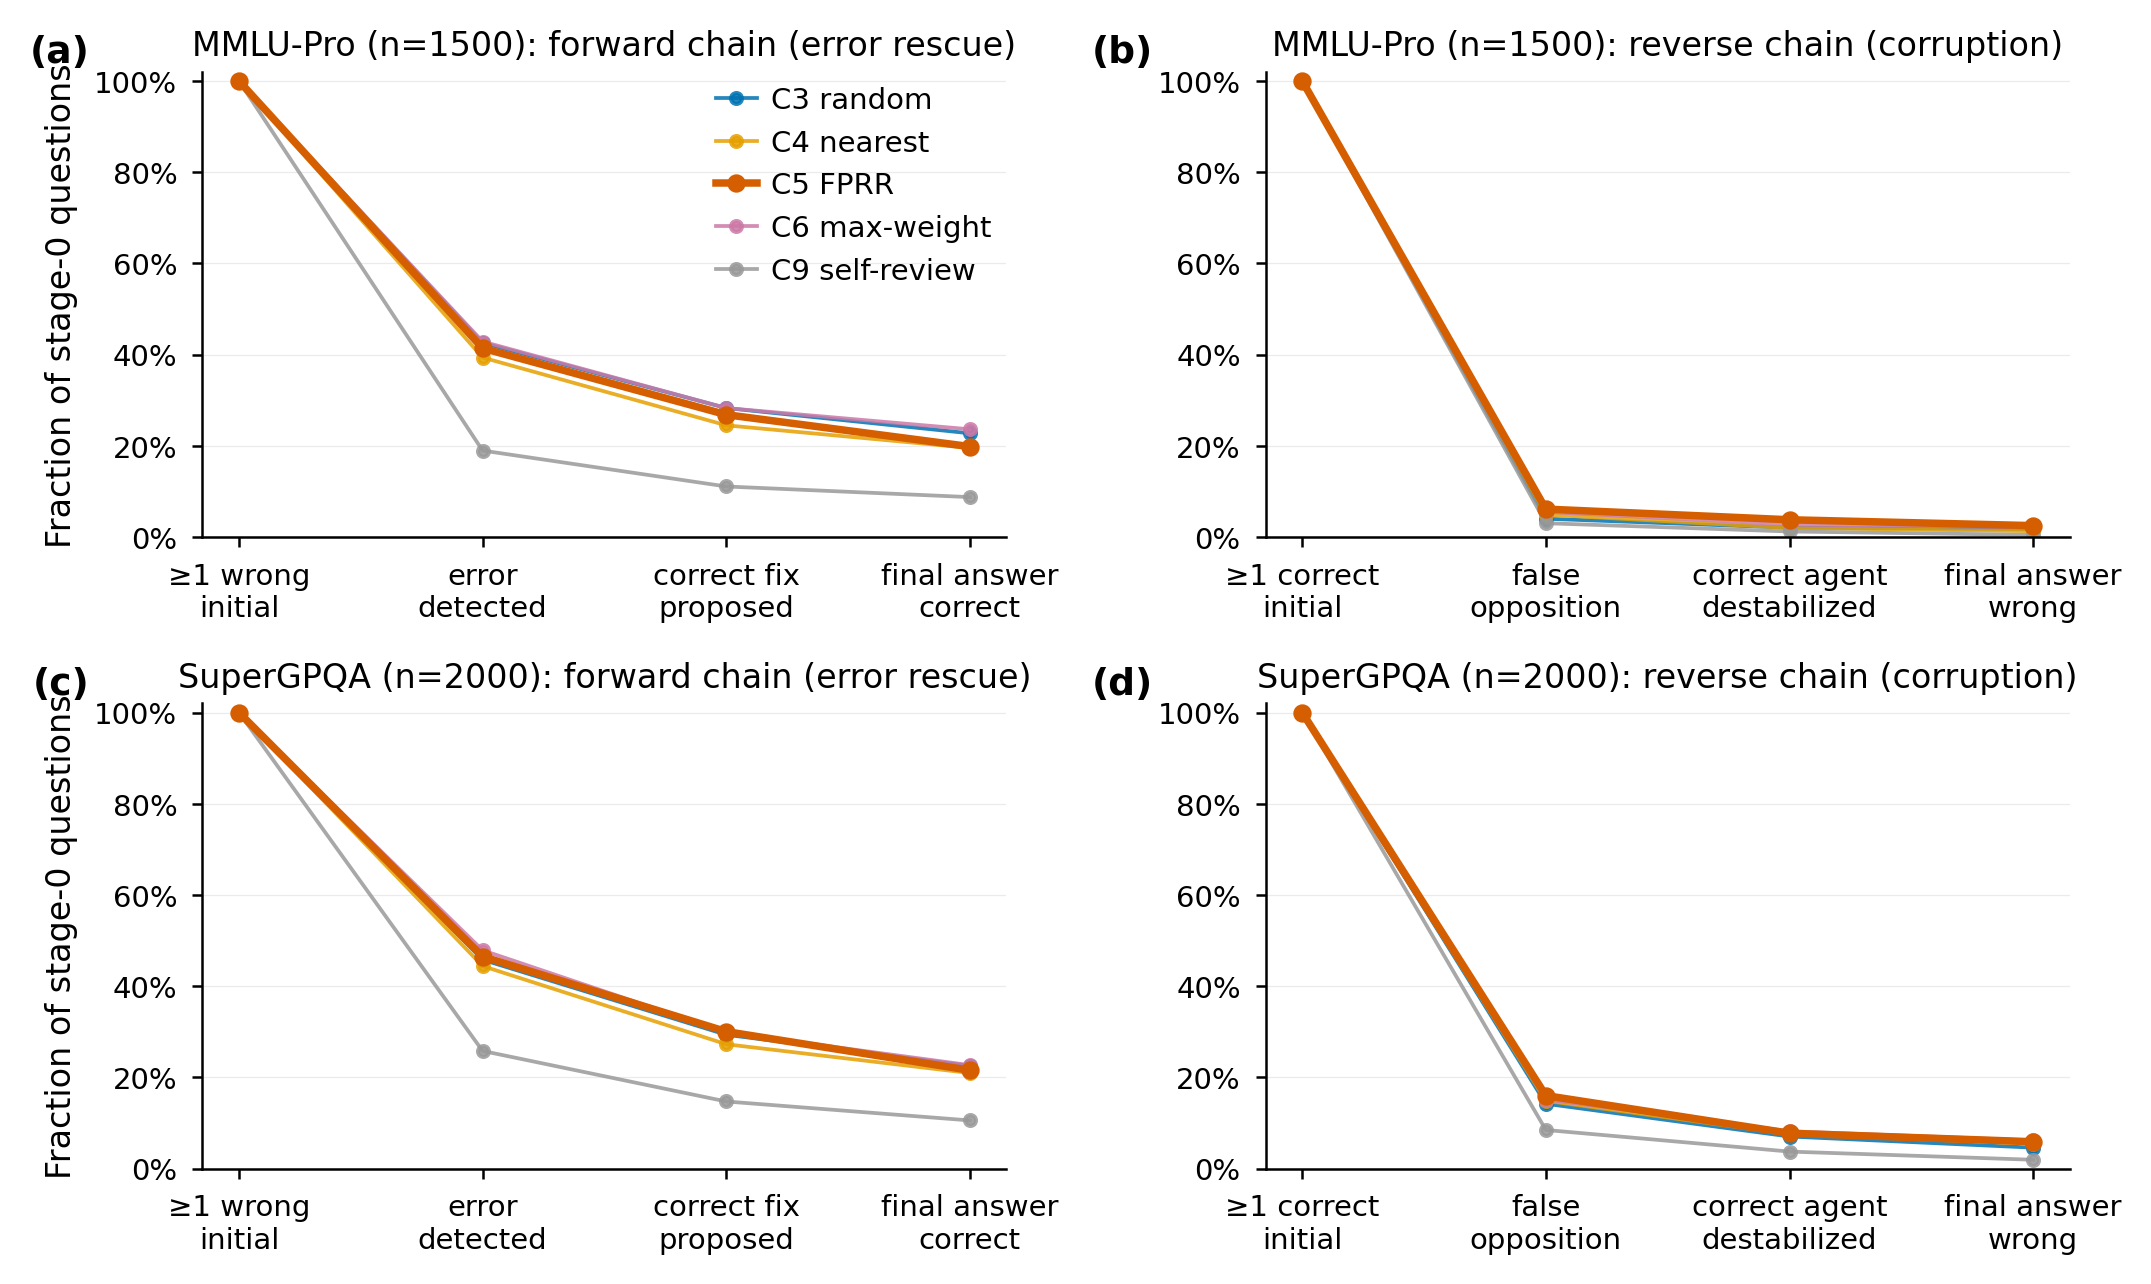
Le résultat nul global soulève une question plus fine : l'arête disassortative porte-t-elle un quelconque signal supplémentaire, et si oui, où meurt-il ? Nous décomposons l'étape de révision en deux chaînes qui courent en directions opposées (Figure 6) : une chaîne avant — une question a au moins une réponse initiale erronée (E0), un réviseur détecte l'erreur (E1), une correction correcte est proposée (E2) et la réponse finale est correcte (E3) — et une chaîne inverse — une question a au moins une réponse initiale correcte (C0), un réviseur s'oppose à tort à un pair correct (C1), un réviseur correct est déstabilisé jusqu'à changer ou douter d'une réponse valide (C2), et la réponse finale est erronée (C3).
FPRR déplace bien le trafic de révision vers les paires où le désaccord est possible. En comptant les révisions dirigées selon l'exactitude du réviseur et du révisé, C5 place \(412/6000\) (\(6.9\%\)) des révisions MMLU-Pro sur des paires mixtes correct–incorrect, contre \(328\) (\(5.5\%\)) sous appariement aléatoire et \(320\) (\(5.3\%\)) sous appariement des plus proches — une augmentation relative de \(25\)–\(30\%\) des arêtes inter-erreurs, à égalité avec l'appariement exact de poids maximal (C6 : \(416\), \(6.9\%\)). Sur SuperGPQA, le déplacement est plus faible : C5 place \(1270/8000\) (\(15.9\%\)) des révisions sur des paires mixtes contre \(1194\) (\(14.9\%\)) sous appariement aléatoire et \(1098\) (\(13.7\%\)) sous appariement des plus proches (C6 : \(1330\), \(16.6\%\)).
Le Tableau 7 stratifie toutes les révisions C5 par décile de distance de paire, et le Tableau 8 donne les résultats globaux au niveau révision. La détection augmente fortement avec la distance sur les deux benchmarks et sous les quatre règles d'appariement, avec de menues non-monotonies locales (Figure 8) : sous C5, P(verdict INCORRECT \(\mid\) révisé erroné) grimpe de \(0.000\) à \(0.379\) sur MMLU-Pro et de \(0.050\) à \(0.361\) sur SuperGPQA entre les déciles extrêmes ; sur C3–C6, le taux de détection du décile supérieur s'étend de \(0.368\)–\(0.436\) (MMLU-Pro) et \(0.301\)–\(0.361\) (SuperGPQA). La révision par les pairs détecte aussi les réponses erronées bien plus souvent que l'auto-révision (C9 : \(0.091\) / \(0.135\) vs \(0.19\)–\(0.26\) pour C3–C6). Notons que C6 — et non C5 — atteint le taux de détection le plus élevé sur MMLU-Pro (\(0.227\)), tout en égalant C3/C4 en exactitude : la détection supplémentaire au-delà de la baseline aléatoire n'a aucun bénéfice global sous aucune règle de routage.
| MMLU-Pro (6000 révisions) | SuperGPQA (8000 révisions) | |||||||
| Décile | intervalle dist. | det | cor | f.o. | intervalle dist. | det | cor | f.o. |
| 1 | [0.000, 0.028] | 0.000 | 0.000 | 0.002 | [0.000, 0.034] | 0.050 | 0.021 | 0.027 |
| 2 | [0.028, 0.043] | 0.073 | 0.018 | 0.002 | [0.034, 0.051] | 0.083 | 0.026 | 0.018 |
| 3 | [0.043, 0.056] | 0.089 | 0.051 | 0.006 | [0.051, 0.066] | 0.178 | 0.079 | 0.030 |
| 4 | [0.056, 0.069] | 0.089 | 0.013 | 0.009 | [0.066, 0.078] | 0.233 | 0.123 | 0.039 |
| 5 | [0.069, 0.081] | 0.105 | 0.058 | 0.016 | [0.078, 0.090] | 0.229 | 0.139 | 0.079 |
| 6 | [0.081, 0.094] | 0.200 | 0.130 | 0.023 | [0.090, 0.104] | 0.258 | 0.129 | 0.065 |
| 7 | [0.094, 0.111] | 0.156 | 0.094 | 0.013 | [0.104, 0.119] | 0.279 | 0.155 | 0.072 |
| 8 | [0.111, 0.130] | 0.236 | 0.127 | 0.030 | [0.119, 0.138] | 0.262 | 0.139 | 0.100 |
| 9 | [0.130, 0.161] | 0.256 | 0.103 | 0.043 | [0.138, 0.168] | 0.268 | 0.151 | 0.090 |
| 10 | [0.161, 1.000] | 0.379 | 0.209 | 0.051 | [0.168, 1.000] | 0.361 | 0.171 | 0.097 |
| MMLU-Pro | SuperGPQA (4 graines) | |||||
| Condition | \(n\) révisions | det | f.o. | \(n\) révisions | det | f.o. |
| C3 aléatoire | 5928 | 0.202 | 0.012 | 7561 | 0.241 | 0.054 |
| C4 plus proche | 5918 | 0.192 | 0.016 | 7568 | 0.231 | 0.057 |
| C5 FPRR | 5912 | 0.212 | 0.020 | 7570 | 0.256 | 0.063 |
| C6 poids maximal | 5902 | 0.227 | 0.018 | 7561 | 0.254 | 0.062 |
| C9 auto-révision | 5943 | 0.091 | 0.009 | 7668 | 0.135 | 0.037 |
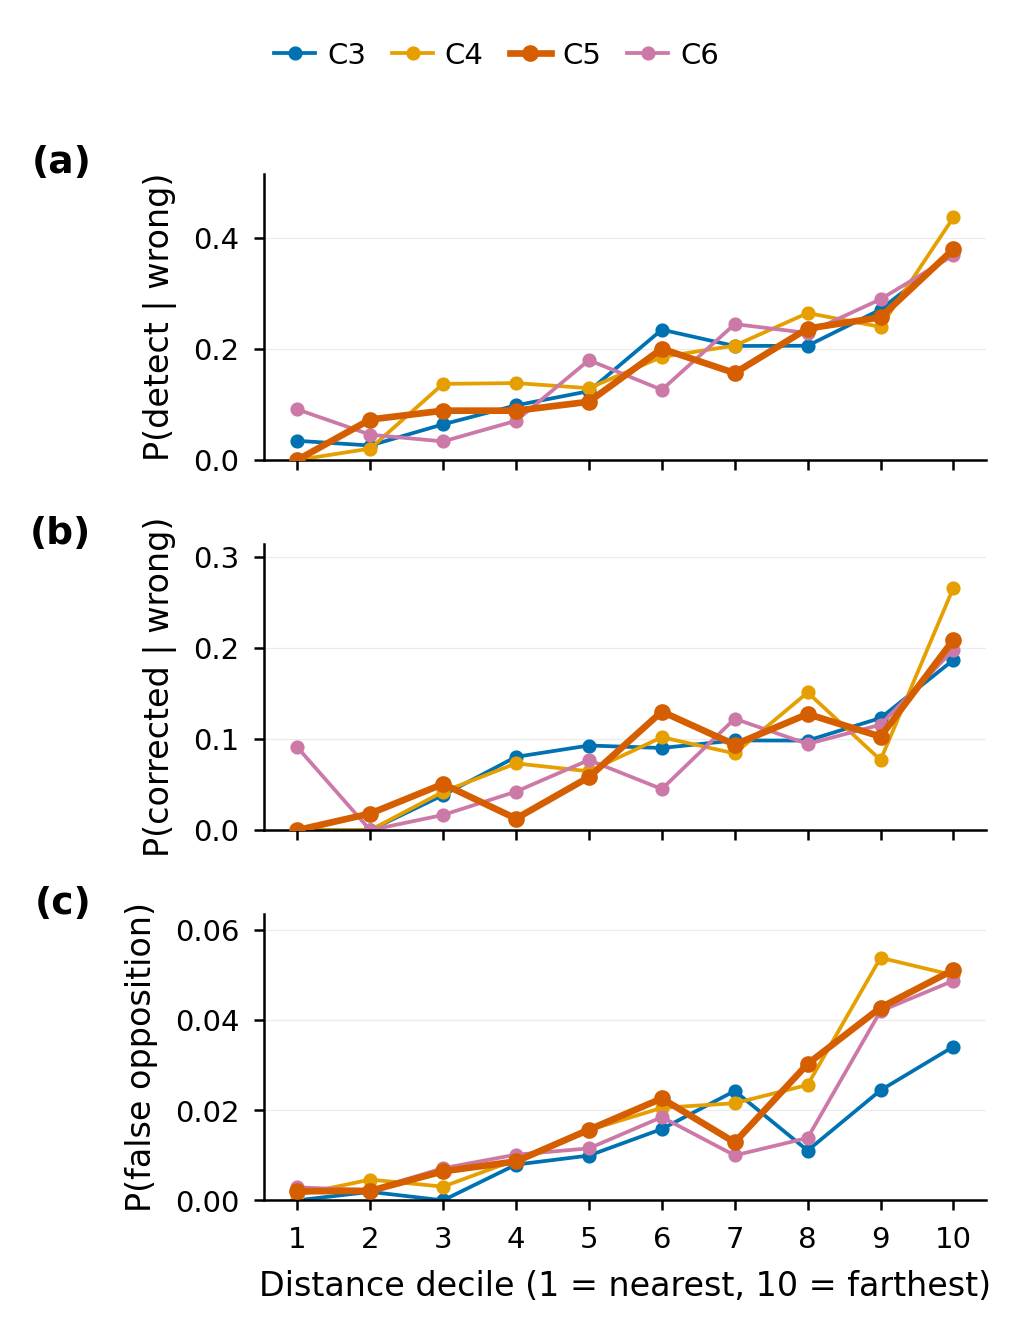
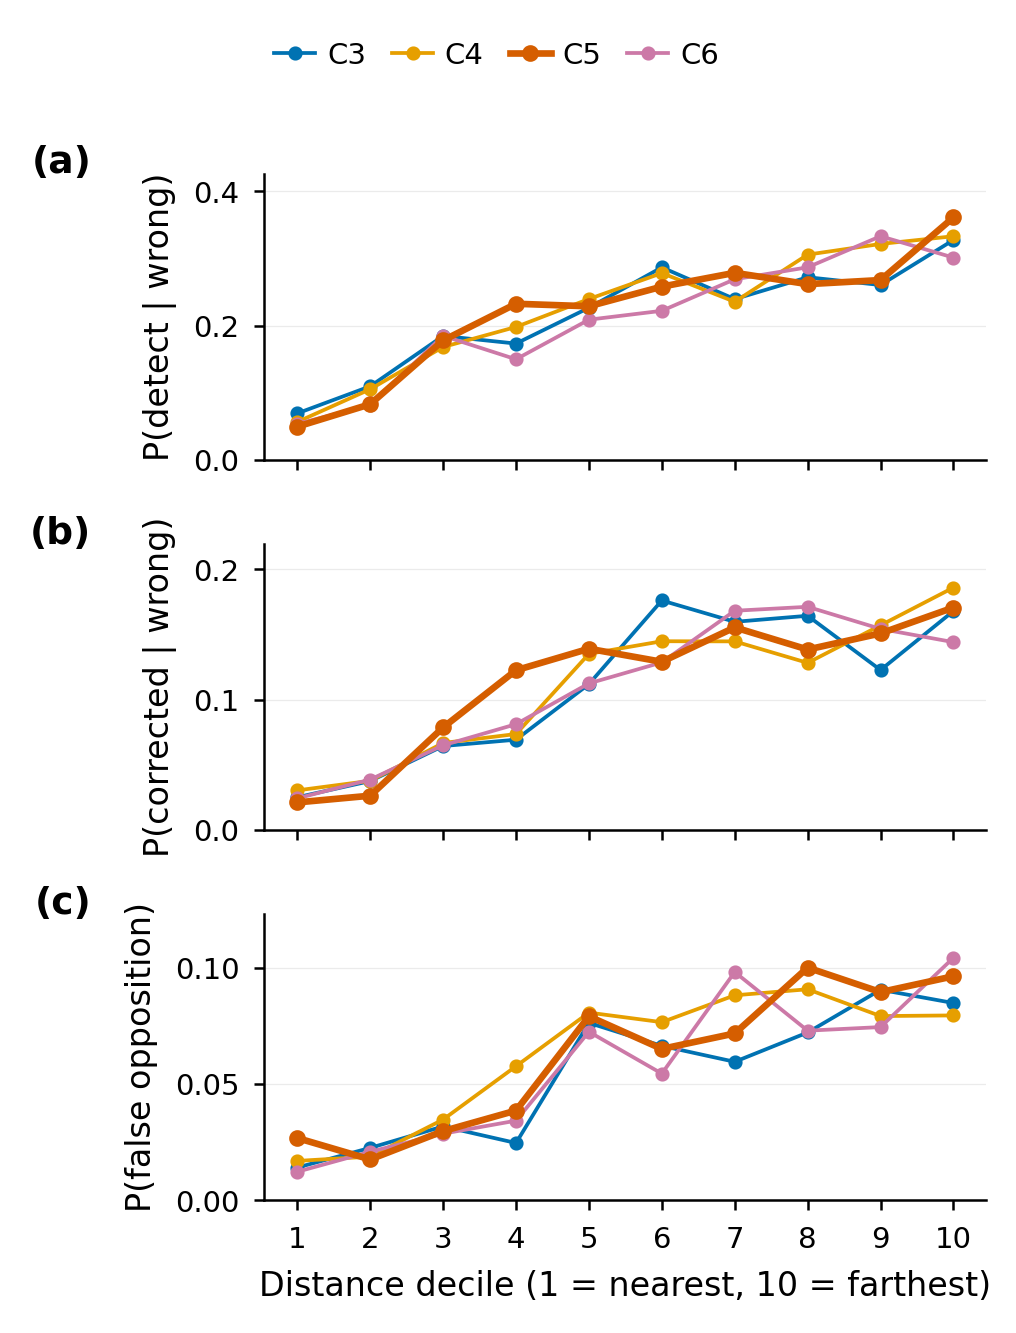
Pour cerner où la distance agit, nous ajustons trois régressions logistiques sur la distance de paire (révisions C3–C6 groupées) : la détection d'un révisé erroné, une correction correcte conditionnellement à la détection, et une réponse finale correcte conditionnellement à l'existence d'une correction (Tableau 9). Sur MMLU-Pro, seule l'étape de détection est sensible à la distance (\(\beta = +12.2\), \(p<0.0001\)) ; la propagation vers la correction (\(p=0.20\)) et l'adoption (\(p=0.84\)) est plate. Sur SuperGPQA, les trois étapes sont significatives (\(\beta = +7.5\), \(+1.7\), \(+7.3\) ; \(p<0.0001\), \(p=0.016\), \(p<0.0001\) respectivement) — la distance se propage bien jusqu'à la résolution là-bas — et pourtant l'exactitude globale ne bouge toujours pas, parce que la chaîne inverse (§7.3) croît avec la même distance. L'énoncé précis est donc : la distance améliore l'exposition à l'erreur ; que l'exposition se propage jusqu'à la résolution dépend du régime.
| Benchmark | Étape (résultat) | \(n\) | \(\beta_{\mathrm{dist}}\) (SE) | \(p\) |
|---|---|---|---|---|
| MMLU-Pro | P(détection \(\mid\) révisé erroné) | 4040 | \(+12.20\) (0.75) | \(<0.0001\) |
| MMLU-Pro | P(correction correcte \(\mid\) détecté) | 796 | \(+1.64\) (1.29) | \(0.203\) |
| MMLU-Pro | P(finale correcte \(\mid\) correction existante) | 321 | \(-0.52\) (2.66) | \(0.844\) |
| SuperGPQA | P(détection \(\mid\) révisé erroné) | 14124 | \(+7.54\) (0.37) | \(<0.0001\) |
| SuperGPQA | P(correction correcte \(\mid\) détecté) | 3161 | \(+1.68\) (0.70) | \(0.016\) |
| SuperGPQA | P(finale correcte \(\mid\) correction existante) | 1224 | \(+7.30\) (1.52) | \(<0.0001\) |
Un oracle de sélection des réponses initiales — qui choisirait toujours la meilleure des quatre réponses initiales mises en cache — atteindrait \(0.883\) sur MMLU-Pro et \(0.697\) sur SuperGPQA, contre \(0.845\) et \(0.614\) pour la meilleure condition réelle (écarts de \({\approx}3.7\)pp et \(8.3\)pp, calculés à partir des valeurs non arrondies \(0.8827\) vs \(0.8453\) et \(0.6965\) vs \(0.614\) ; les valeurs arrondies du tableau suggèrent \(3.8\)pp). Un travail concomitant aboutit au même diagnostic à bien plus grande échelle : sur 15,336 questions et 81,390 pools de candidats fixes, Ji et al. [41] montrent que les réponses correctes sont fréquemment présentes dans l'ensemble des candidats sans être sélectionnées, et que la fiabilité du juge varie avec la tâche, le générateur et la rareté de la réponse correcte. Notre écart à l'oracle de sélection confirme ce goulot d'étranglement de l'offre de candidats sous des ensembles de réponses identiques entièrement contrôlés, et l'étend en mesurant ce que la révision ajoute au-delà du pool de candidats. Cet oracle n'est cependant pas le plafond d'un système de délibération, car les réviseurs peuvent générer des réponses absentes de l'ensemble initial \(R_x\). Et ils le font réellement : sur les questions où les quatre réponses initiales sont erronées (176/1500 sur MMLU-Pro, \(11.7\%\) ; 607/2000 sur SuperGPQA, \(30.4\%\)), la révision a produit une réponse correcte hors de \(R_x\) dans \(0\)–\(2.3\%\) (MMLU-Pro) et \(3.1\)–\(4.1\%\) (SuperGPQA) des cas toutes conditions confondues — la sortie de l'étape de révision n'est empiriquement pas une fonction des seules réponses initiales.
Mais c'est la livraison qui tue cette information nouvelle (Tableau 10). De bout en bout, une proposition correcte nouvelle a atteint la réponse finale dans \(1/176\) questions (\(0.6\%\)) sous C5 sur MMLU-Pro et au plus \(9/607\) (\(1.5\%\)) sur SuperGPQA (C9 ; C5 : \(8/607 = 1.3\%\)) ; la colonne « proposées, non livrées » quantifie la perte — p. ex. C3 a proposé \(4\) réponses correctes nouvelles sur MMLU-Pro et n'en a livré aucune, et C5 en a proposé \(25\) sur SuperGPQA et n'en a adopté que \(6\) (\(19\) perdues). Dans le sous-ensemble unanimement erroné (120 et 401 questions), la réponse finale de chaque condition reste erronée dans au moins \(99.2\%\) (MMLU-Pro) et \(98.0\%\) (SuperGPQA) des cas : la révision peut créer la réponse manquante, mais le pipeline ne sait pas la reconnaître.
| MMLU-Pro | SuperGPQA (4 graines) | |||||||
| Condition | nouv. prop. | fin. corr. | adoptées | prop. non livr. | nouv. prop. | fin. corr. | adoptées | prop. non livr. |
| C3 | 4 | 0 | 0 | 4 | 21 | 8 | 7 | 14 |
| C4 | 3 | 0 | 0 | 3 | 20 | 8 | 6 | 14 |
| C5 | 2 | 1 | 1 | 1 | 25 | 8 | 6 | 19 |
| C6 | 0 | 0 | 0 | 0 | 19 | 7 | 6 | 13 |
| C9 | 1 | 0 | 0 | 1 | 21 | 9 | 8 | 13 |
Notre explication de travail de l'ère pilote pour la corruption des majorités correctes était l'amplification des valeurs aberrantes : l'appariement des plus distants câblerait préférentiellement l'unique valeur aberrante erronée à un agent correct. Les données complètes la réfutent comme mécanisme global. Au sein des répartitions de réponses 3:1 — en contrôlant la difficulté des questions en ne comparant que des questions de même structure de répartition — le singleton est en effet bien moins susceptible d'être correct que la majorité (\(20.8\%\) vs \(57.6\%\) sur MMLU-Pro ; \(28.4\%\) vs \(44.7\%\) sur SuperGPQA) : les réponses distantes et inhabituelles sont disproportionnellement erronées. Mais les extrémités de l'arête de distance maximale de chaque question sont erronées essentiellement au taux de base (\(17.1\%\) vs \(16.3\%\) pour l'arête de distance minimale, taux de base \(16.8\%\), MMLU-Pro ; \(44.7\%\) vs \(43.6\%\), base \(44.1\%\), SuperGPQA) : l'appariement des plus distants ne sélectionne pas systématiquement de partenaires erronés. Nous retirons donc l'amplification des valeurs aberrantes comme explication globale ; le résultat 3:1 ne vaut que comme « les réponses aberrantes ont une faible exactitude », et non « FPRR choisit de mauvais partenaires ».
Ce que la chaîne inverse montre à la place, c'est l'opposition erronée et la déstabilisation des réponses valides. L'opposition erronée augmente avec la distance de paire (Tableau 7 : de \(0.002\) à \(0.051\) sous C5 sur MMLU-Pro ; jusqu'à \(0.104\) sous appariement de poids maximal sur SuperGPQA). Au niveau question (Figure 6, côté C), la déstabilisation des réviseurs corrects est plus lourde sous C5 que sous C3 sur MMLU-Pro (\(50/1324 = 4\%\) vs \(27/1324 = 2\%\) ; finale-erronée \(33\) vs \(23\)) — C5 coiffe l'entonnoir inverse de MMLU-Pro — tandis que sur SuperGPQA la chaîne inverse est lourde pour toutes les conditions de révision (\(0.07\)–\(0.08\) déstabilisées). La dissimilarité sémantique ne route pas vers des partenaires erronés ; elle fabrique de l'opposition à des partenaires corrects.
Les métriques secondaires pré-enregistrées (Tableau 11) et les transitions de consensus (Figure 10) quantifient le bilan qui en résulte. Les conditions de révision récupèrent les erreurs de la majorité plus souvent que le vote — mais c'est l'appariement aléatoire, et non FPRR, qui est nominalement le meilleur sur MMLU-Pro (récupération \(0.099\) ; sauvetage \(0.082\)), et sur SuperGPQA le synthétiseur sans révision C2 (\(0.099\) / \(0.100\)) égale les meilleures conditions de révision (C4 : \(0.098\) / \(0.106\)) sans aucune révision, tandis que C5 est la plus faible condition de révision hormis C9 (\(0.089\) / \(0.096\)). Par rapport à la réponse initiale de l'agent 0, les conditions de révision MMLU-Pro basculent \(15.2\)–\(18.0\%\) des cas initialement erronés vers correct tout en corrompant \(1.5\)–\(2.1\%\) des cas initialement corrects (C5 : \(16.0\%\) / \(2.1\%\) ; vote C1 : \(11.7\%\) / \(0.5\%\)) ; sur SuperGPQA, le compromis est presque symétrique (C5 : \(17.2\%\) vs \(6.8\%\)) — ce qui explique exactement pourquoi aucun gain net ne se matérialise sur le benchmark plus difficile.
| MMLU-Pro | SuperGPQA (4 graines) | |||||
| Condition | rec | cor | res | rec | cor | res |
| C0 | 0.026 | 0.024 | 0.032 | 0.048 | 0.094 | 0.064 |
| C2 | 0.065 | 0.022 | 0.050 | 0.099 | 0.040 | 0.100 |
| C3 | 0.099 | 0.019 | 0.082 | 0.096 | 0.051 | 0.100 |
| C4 | 0.086 | 0.016 | 0.059 | 0.098 | 0.054 | 0.106 |
| C5 | 0.078 | 0.021 | 0.059 | 0.089 | 0.059 | 0.096 |
| C6 | 0.086 | 0.017 | 0.064 | 0.096 | 0.058 | 0.099 |
| C9 | 0.065 | 0.019 | 0.036 | 0.070 | 0.051 | 0.075 |
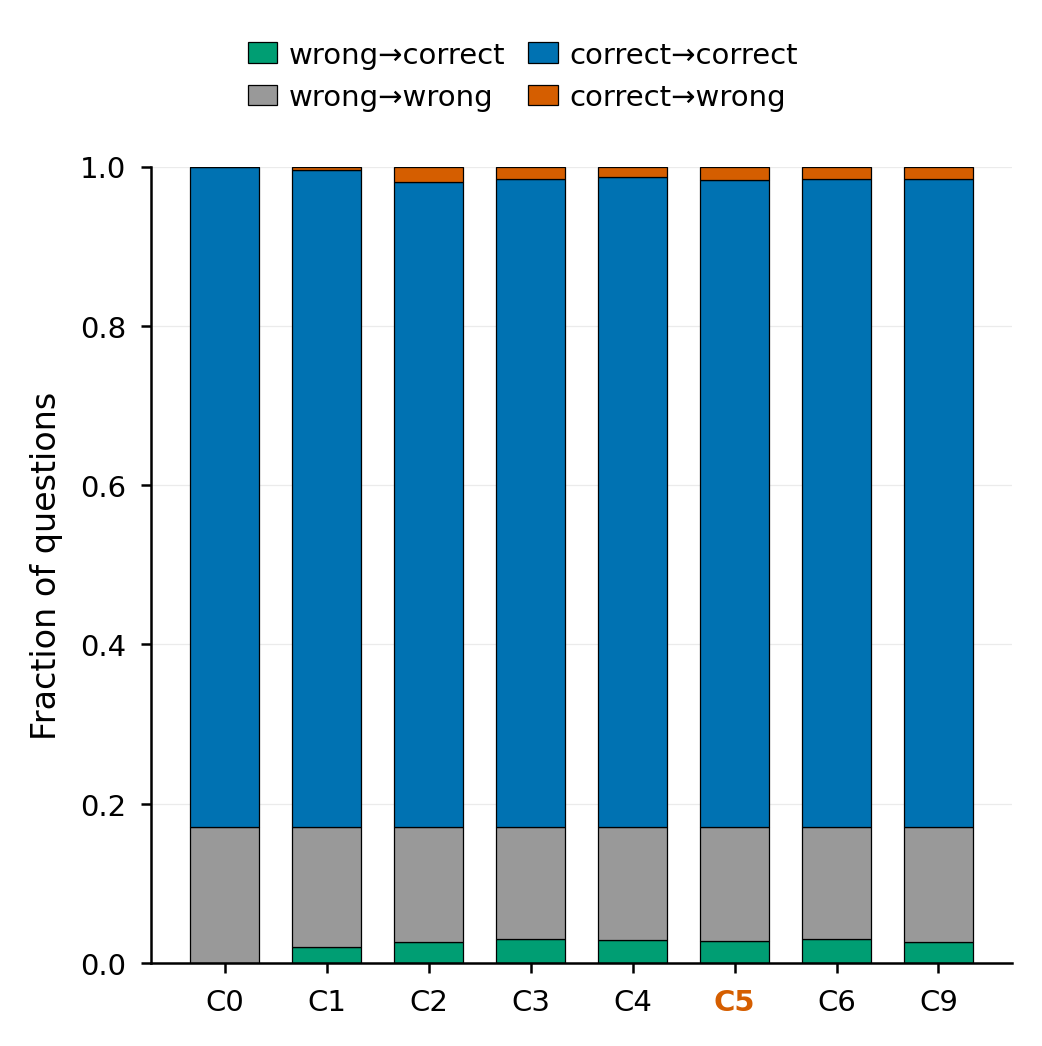
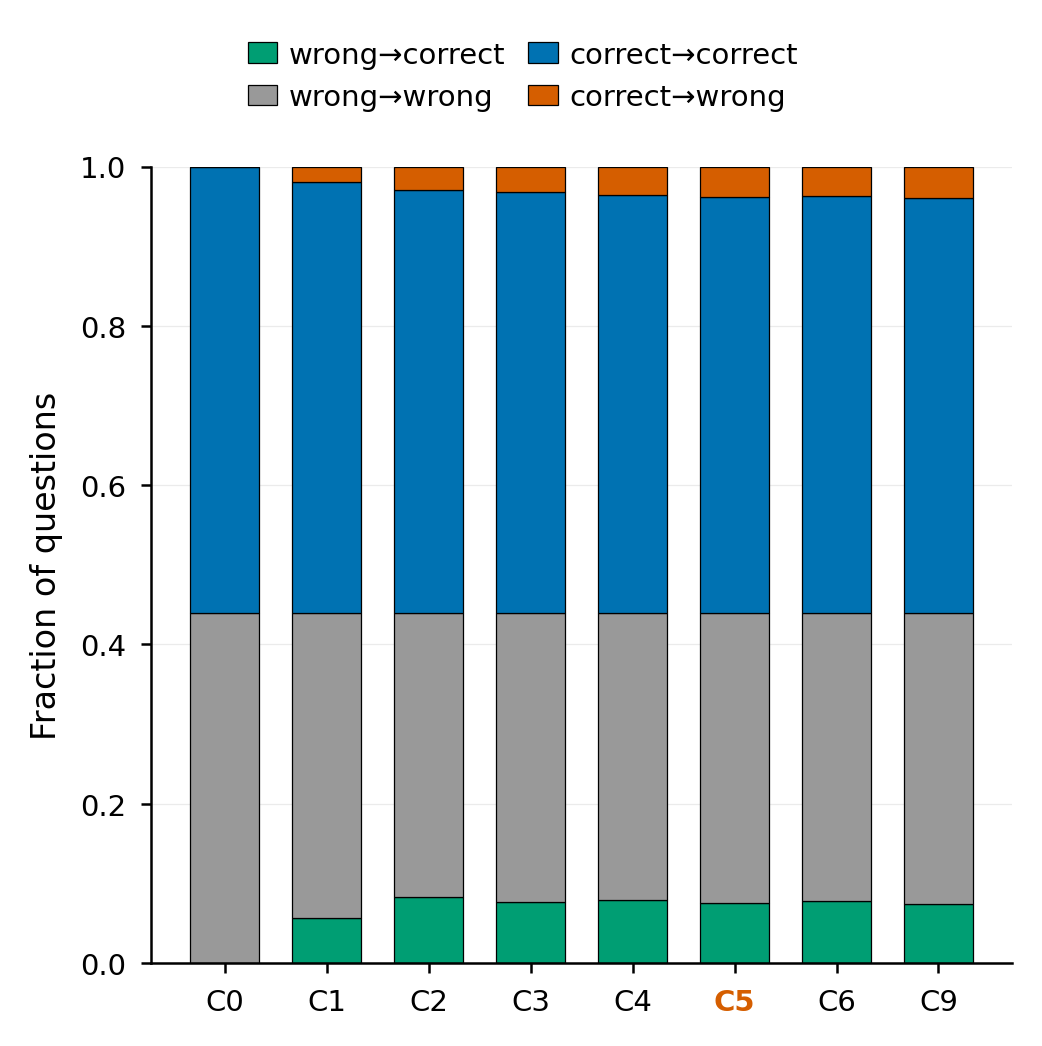
Que C5 égale le contrôle d'auto-révision C9 en exactitude pourrait signifier que la révision est redondante — ou qu'elle est active dans les deux sens et s'annule. Les transitions C2\(\leftrightarrow\)C5 au niveau question tranchent : l'ajout des révisions au même pipeline de synthèse bascule \(27\) questions MMLU-Pro d'erroné à correct et \(23\) de correct à erroné (net \(+4\) ; \(1450\) inchangées), et \(49\) vs \(79\) sur SuperGPQA (net \(-30\) ; \(1872\) inchangées). La révision est active, et sur SuperGPQA activement nette-négative — reflétant l'écart significatif C2 \(>\) C5 du Tableau 4. Nous résumons cela par le Beneficial Transition Ratio (taux de transitions bénéfiques), \(\mathrm{BTR} = \#\text{rescued} / (\#\text{rescued} + \#\text{harmed})\) : \(0.54\) sur MMLU-Pro et \(0.383\) sur SuperGPQA. (Le BTR est calculé à partir des comptes de transitions par question C2 vs C5 ; ce n'est pas une précision sur tous les événements de révision de réponse, ce qui exigerait un audit séparé de chaque modification induite par une révision.)
Une critique de dilution soutient que le résultat nul global est non informatif parce que la plupart des questions sont unanimes et qu'aucune topologie ne peut y agir. Nous restreignons donc l'analyse au sous-ensemble de désaccord (réponses initiales non unanimes ; \(223\) questions, \(14.9\%\), sur MMLU-Pro ; \(754\), \(37.7\%\), sur SuperGPQA) et au sous-ensemble récupérable (questions de désaccord dont la réponse correcte figure parmi les initiales ; \(59\), \(3.9\%\) ; et \(234\), \(11.7\%\)). Le Tableau 12 rejette la réfutation par dilution sans autoriser non plus d'affirmation conditionnelle : C5 est devancé par C3 sur les deux benchmarks — de \(3.1\)pp et \(13.6\)pp sur les sous-ensembles de désaccord et récupérable de MMLU-Pro, et de \(2.0\)pp et \(1.7\)pp sur les sous-ensembles SuperGPQA correspondants (C5 vs C4 sur SuperGPQA récupérable : \(-3.4\)pp). La direction est désormais uniformément négative sur les deux benchmarks, mais chaque intervalle de confiance croise zéro — là où la topologie a de la place pour agir, FPRR ne montre aucun bénéfice et une pénalité constante, non significative.
| Benchmark | Sous-ensemble | \(n\) | exactitude C3 | exactitude C5 | C5\(-\)C3 (pp) | IC 95% (pp) |
|---|---|---|---|---|---|---|
| MMLU-Pro | désaccord | 223 | 0.498 | 0.466 | \(-3.1\) | [\(-8.1\), \(+1.8\)] |
| MMLU-Pro | récupérable | 59 | 0.475 | 0.339 | \(-13.6\) | [\(-25.4\), \(+0.0\)] |
| SuperGPQA | désaccord | 754 | 0.488 | 0.468 | \(-2.0\) | [\(-4.8\), \(+0.8\)] |
| SuperGPQA | récupérable | 234 | 0.402 | 0.385 | \(-1.7\) | [\(-8.6\), \(+5.1\)] |
Pour répondre directement à la question de l'article : les arêtes des paires les plus distantes portaient un signal que les arêtes aléatoires et les plus proches portaient moins — davantage de détections de pairs réellement erronés (\(301\) vs \(254\) et \(260\) verdicts PEER INCORRECT sur MMLU-Pro ; détection \(0.212\) vs \(0.202\)/\(0.192\)), concentrées dans les déciles de haute distance où la détection vaut \(3\)–\(10\times\) le taux des déciles bas. Trois résultats résument où ce signal est allé. (a) La distance sémantique augmente de façon fiable l'exposition à l'erreur ; que l'exposition se propage à la réparation et à l'adoption dépend du régime (MMLU-Pro : détection seule ; SuperGPQA : les trois étapes), et la chaîne inverse croît avec la même distance à chaque étape — le gain net est donc nul sur MMLU-Pro et négatif sur SuperGPQA (BTR \(0.54\) vs \(0.383\)). (b) La révision génère des réponses correctes nouvelles au-delà de l'oracle de sélection des réponses initiales sur \(0\)–\(4\%\) des questions entièrement erronées, mais la livraison de bout en bout est \(\le 1.5\%\), et la plupart des propositions se perdent entre proposition et adoption. (c) La contrainte limitante est l'attribution épistémique du crédit : sans validation asymétrique, le système ne peut distinguer le désaccord correctif de l'opposition erronée. Différent \(\neq\) instructif.
Quatre questions MMLU-Pro (toutes graine 0) illustrent les mécanismes quantifiés ci-dessus ; transcriptions complètes, matrices de distance et finales par condition se trouvent dans results/case_studies_mmlu_pro.md.
Une question de conception d'échangeur de chaleur (référence : D). Les quatre agents répondent B, E, D, C — une majorité erronée (B) avec un seul agent correct (2). C5 apparie \((0,1)\) et \((2,3)\) ; l'agent 2 juge l'agent 3 PEER INCORRECT, et l'agent 3 se met à jour vers D et approuve l'agent 2 (PEER CORRECT). Le synthétiseur récupère D, tandis que C0, C1, C2 et C9 produisent tous le B de la majorité. C'est le pipeline fonctionnant comme prévu — bien que C3, C4 et C6 récupèrent aussi D ici, ce succès n'est donc pas spécifique à l'appariement des plus distants.
Un empilement polariseur/lame demi-onde (référence : J). Les agents 0 et 1 ne produisent pas de réponse analysable ; l'agent 2 seul répond J, l'agent 3 répond C. Sous C5 (paires \((0,1)\), \((2,3)\)), les quatre révisions convergent : les deux agents de la paire correcte approuvent J, l'agent 2 signale l'agent 3 comme PEER INCORRECT, et chaque réviseur se met à jour vers J. Toutes les conditions d'agrégation récupèrent J ; seul C0 (agent 0) reste erroné. La révision convertit un unique échantillon correct fragile en consensus — mais le simple vote le fait aussi ici (les réponses non analysables ne votent pas), montrant encore que la topologie n'est pas l'ingrédient actif.
Une question de puissance d'écoulement en conduite (référence : D). Trois agents répondent D ; l'agent aberrant 2 répond A. L'appariement des plus distants (C5, et à l'identique C6) câble la valeur aberrante à l'agent correct 0. La valeur aberrante déclare l'agent 0 PEER INCORRECT et garde A ; pendant ce temps, l'agent 3, révisant le D correct de l'agent 1, bascule vers H. Face à un dossier de révision perturbé, le synthétiseur produit A pour C5 (et C3) — une majorité correcte détruite — tandis que C4 et C6 restent à D. Nous présentons cela comme une instance du mécanisme de déstabilisation du §7.3 — un pair distant fabriquant de l'opposition à des réponses correctes — et non comme une preuve que l'appariement des plus distants sélectionne systématiquement des partenaires erronés : au niveau global, ce n'est pas le cas (les extrémités des arêtes de distance maximale se trompent au taux de base).
Une question de projectile et conservation de l'énergie (référence : I). Les quatre agents répondent indépendamment A, avec des distances deux à deux de \(0.099\)–\(0.243\) provenant uniquement de justifications formulées différemment pour la même dérivation erronée. Toutes les révisions C5 renvoient PEER CORRECT, et chaque condition — de C0 à C9 — produit A. La distance de plongement sépare les formulations ; l'idée fausse est partagée, de sorte que la révision disassortative finit par la certifier.
À réponses initiales, invites et calcul identiques, le qui de la révision par les pairs ne compte pas : les appariements des plus distants, des plus proches, aléatoire et exact de poids maximal se tiennent à 0.6pp les uns des autres sur MMLU-Pro et à 0.4pp sur SuperGPQA, et aucun ne bat le vote majoritaire ni l'auto-révision à calcul apparié. Cela étend à la dimension du routage le tableau émergeant selon lequel la communication entre agents homogènes bat rarement l'agrégation [6, 7] : ce n'est pas seulement le débat par diffusion qui n'ajoute aucune valeur — aucun câblage deux à deux des mêmes échantillons n'en ajoute non plus.
FPRR a été conçu sur la prémisse que les réponses échantillonnées forment des clusters de raisonnement corrélés et qu'apparier à travers les clusters maximise le contraste diagnostique. La prémisse tient, mais les clusters sont trop petits pour être contournés par le routage. Sur MMLU-Pro, \(85.1\%\) des observations sont unanimes (\(77.1\%\) unanimement correctes, \(8.0\%\) unanimement erronées), le nombre moyen de réponses uniques parmi quatre échantillons est \(1.166\), et la distance cosinus moyenne deux à deux est \(0.087\) ; SuperGPQA est plus disputé mais reste peu diversifié (\(62.3\%\) unanimes, \(1.355\) réponses uniques, distance moyenne \(0.095\)). Quand trois agents sur quatre disent la même chose, chaque règle d'appariement produit presque le même ensemble d'arêtes à une paire près — ce que montrent exactement les tableaux d'exactitude. Le routage disassortatif présuppose une masse de désaccord exploitable ; à température \(0.8\) avec un modèle fort sur des benchmarks saturés, cette masse est minimale.
Les résultats mécanistiques séparent deux quantités que la littérature sur le débat confond souvent. La distance sémantique augmente robustement l'exposition à l'erreur : les réviseurs signalent les pairs erronés jusqu'à un ordre de grandeur plus souvent dans le décile de distance supérieur que dans l'inférieur. Mais la propagation de cette exposition vers la réparation et l'adoption dépend du régime — plate sur MMLU-Pro, significative aux trois étapes sur SuperGPQA — et une chaîne inverse croît partout avec la même distance : opposition erronée (jusqu'à \(0.10\) dans le décile supérieur) et déstabilisation des réviseurs corrects (\(4\%\) des questions sous C5 vs \(2\%\) sous C3 sur MMLU-Pro). Fait notable, la chaîne inverse ne s'explique pas par une sélection de mauvais partenaires par l'appariement des plus distants : les extrémités des arêtes de distance maximale se trompent au taux de base. Ce qui bride les pipelines fondés sur la révision dans ce régime, c'est l'attribution épistémique du crédit : une réponse distante et argumentée avec assurance semble identique pour le réviseur et le synthétiseur, qu'elle corrige une erreur ou invente une objection, de sorte que sans validation asymétrique, chaque unité d'exposition achetée par la topologie est remboursée en déstabilisation.
Là où les conditions multi-échantillons battent effectivement la baseline unique — le plus nettement sur SuperGPQA, \({\approx}+4\)pp pour toutes les conditions \(N{=}4\) face à C0 — le gain est capturé à parts égales par le vote et la synthèse sans révision ; en fait, sur SuperGPQA la synthèse sans révision dépasse significativement la révision par les pairs (C2 vs C5 : \(+1.5\)pp, \(p=0.010\) non corrigé), de sorte que sur le benchmark plus difficile la révision est mesurablement pire que l'absence de révision. Rien dans nos résultats ne suggère que l'évaluation réciproque change ce que le modèle sait ; elle repondère des réponses que le modèle produit déjà, et sur ces benchmarks le vote les repondère tout aussi bien pour un cinquième du coût en tokens. Les rapports de gains fondés sur la révision ou le débat devraient être lus à l'aune d'un contrôle d'auto-révision à calcul apparié et d'un plancher de vote ; dans nos données, les deux rendent entièrement compte de l'effet.
Plusieurs menaces à la validité nuancent ces résultats.
Surcoût de calcul. Les conditions de révision coûtent \({\sim}5\times\) les tokens du vote majoritaire et \({\sim}20\times\) une réponse unique pour un gain global nul ; notre analyse de coût est descriptive et ne teste pas de variantes de révision moins coûteuses (révisions plus courtes, moins de paires).
Les erreurs corrélées sont structurelles. Tous les agents sont un même checkpoint servi par un même fournisseur, de sorte que les erreurs corrélées de même source (idée fausse partagée, \(8.0\%\)–\(21.6\%\) des observations) bornent ce que tout schéma de révision intra-modèle peut récupérer ; des pools de modèles hétérogènes peuvent se comporter différemment.
Contamination des benchmarks. MMLU-Pro et SuperGPQA sont des benchmarks publics et peuvent être partiellement exposés dans les données d'entraînement. La contamination gonfle les exactitudes absolues et comprime la marge ; comme elle s'applique identiquement à chaque condition, les différences appariées restent interprétables, mais les tailles d'effet détectables sont bornées par la marge restante.
Dépendance au plongement. Les distances proviennent d'un seul encodeur (bge-m3) sur le texte conclusion + justification. La distance de plongement mesure une dissimilarité sémantique de surface, pas un désaccord logique — la question qid 10012 montre des idées fausses identiques à distance \(0.24\). L'ablation de métrique exploratoire (Tableau 6) n'atténue cela que partiellement : elle est à graine unique, 200 questions par benchmark, et MMLU-Pro D4 manque ; l'avantage de D4 sur SuperGPQA exige donc une réplication avant de pouvoir peser contre le résultat nul principal.
Biais du juge et du synthétiseur. Le synthétiseur est le même modèle que les agents et peut partager leurs biais (p. ex. vers des réponses assurées ou verbeuses) ; son invite était gelée entre conditions, donc ce biais ne peut expliquer les différences de conditions, mais il façonne tous les résultats des conditions de révision.
Modèle unique, configuration de décodage unique. Un checkpoint, une température (\(0.8\)), un \(N\) dans les runs principaux ; le fournisseur n'expose aucun paramètre de graine, donc le non-déterminisme de l'API n'est pas fixable par graine (tous les éléments stochastiques que nous contrôlons — échantillonnage, appariement, brassages — sont à graine fixée et journalisés). Le résultat nul pourrait ne pas se transférer à des régimes de plus grande diversité (température plus élevée, ensembles hétérogènes, tâches plus dures ou moins saturées) où la masse de désaccord est plus grande.
Portée et dépendance. Deux benchmarks ; SuperGPQA repose sur quatre graines (contre trois pour MMLU-Pro). Les observations inter-graines partagent des questions, donc les IC bootstrap groupés et les valeurs de \(p\) de McNemar sont légèrement anti-conservateurs — ce qui, le cas échéant, rend les conclusions nulles conservatrices pour les comparaisons principales, dont aucune n'approche la significativité. L'ablation de \(N\) et l'étude de variance de graine d'appariement pré-enregistrées (Amendement 8) n'ont pas été exécutées pour des raisons de budget ; nous ne pouvons donc pas quantifier la sensibilité du résultat nul à \(N\) ou au hasard d'appariement ; l'ablation de distance est à graine unique.
Selon les critères de décision pré-enregistrés, cette étude se classe en catégorie de résultat D — un résultat nul : sur des réponses mises en cache identiques, l'évaluation réciproque des paires les plus distantes est statistiquement indiscernable de l'appariement aléatoire, de l'appariement des plus proches, de l'appariement exact de poids maximal, du vote majoritaire et de l'auto-révision à calcul apparié sur MMLU-Pro (final, 3 graines) et SuperGPQA (4 graines), avec toutes les tailles d'effet principales à moins de \(\pm 1\)pp et toutes les valeurs de \(p\) ajustées par Holm \(\geq 0.92\). Qui révise qui ne compte pas — dans ce régime. Il semble même que la révision soit légèrement pire que l'absence de révision sur le benchmark plus difficile (C2 \(>\) C5 de \(1.5\)pp, \(p=0.010\) non corrigé). Une note exploratoire nuance, sans la changer, cette classification : dans l'ablation de distance à graine unique, la métrique sensible au désaccord par contradiction NLI (D4) surpasse la distance sémantique pure sur le benchmark plus difficile (D4 \(-\) D2 \(= +3.0\)pp, IC \([+0.5, +6.0]\), \(7\) vs \(1\) discordantes ; Tableau 6) — premier indice que c'est l'opposition épistémique, et non la différence textuelle, qui est la quantité sur laquelle router, reliant ce résultat nul aux travaux sur le routage sensible au désaccord.
L'analyse mécanistique est, croyons-nous, la contribution durable. La distance sémantique augmente de façon fiable l'exposition à l'erreur sur les deux benchmarks et toutes les règles d'appariement, mais que l'exposition se propage à la réparation et à l'adoption dépend du régime — et la chaîne inverse d'opposition erronée et de déstabilisation croît avec la même distance à chaque étape, de sorte que le gain net est nul ou pire. La révision n'est ni redondante ni bornée par l'ensemble des réponses initiales : elle bascule des questions dans les deux sens (BTR \(0.54\) / \(0.383\)) et génère des réponses correctes nouvelles sur \(0\)–\(4\%\) des questions entièrement erronées, mais la livraison de bout en bout de cette information nouvelle est \(\le 1.5\%\). La révision par les pairs entre agents homogènes échoue non parce que les réviseurs ne voient pas le désaccord, ni parce que rien de nouveau ne peut être dit — mais parce que le système ne sait pas attribuer le crédit : sans validation asymétrique, désaccord correctif et opposition erronée sont indiscernables.
Trois directions s'ensuivent. Premièrement, retester le routage disassortatif là où la masse de désaccord est réelle : pools à température plus élevée ou à modèles hétérogènes, tâches moins saturées et \(N\) plus grands. Deuxièmement, stabiliser avant de router : protéger les réponses correctes contre l'opposition erronée induite par la distance (p. ex. synthèse conditionnée par le verdict ou validation asymétrique des contestations), en ciblant directement la chaîne de déstabilisation. Troisièmement, traiter l'attribution épistémique du crédit elle-même comme objet d'étude — calibration des réviseurs, livraison de la proposition à l'adoption, et arbitrage sous révisions conflictuelles — puisque nos entonnoirs et régressions par étape identifient l'attribution du crédit, plutôt que le routage, comme la contrainte limitante du passage à l'échelle au moment du test fondé sur la révision.
Les enregistrements bruts mis en cache (JSONL : invites complètes, sorties brutes, champs analysés, usage de tokens, graines), les sorties d'analyse et les données des figures sont disponibles dans le dépôt du projet. Les jeux de données de benchmark sont publics : MMLU-Pro (CC-BY-4.0) et SuperGPQA (ODC-BY).
Le pipeline expérimental complet et les scripts d'analyse (appariement à graine fixée, analyse syntaxique déterministe, statistiques bootstrap appariées) sont disponibles dans le dépôt du projet.
Tous les auteurs ont contribué à la conception de l'étude, à l'exécution des expériences, à l'analyse des données et à la préparation du manuscrit, et ont approuvé la version finale.
Ce travail a été mené et financé par Gi (Beijing) Tech Design Ltd. ; aucun financement externe n'a été reçu.
Tous les auteurs sont employés de Gi (Beijing) Tech Design Ltd.
Sans objet ; cette étude n'implique ni participants humains, ni animaux, ni données personnelles identifiables.