Qui doit relire qui ?
Relecture par les pairs désassortative conditionnée par les réponses, pour le raisonnement des LLM au moment du test
Rui Li · Chenglong Sun · Xueyan Zheng · Dan Liu
Gi (Beijing) Tech Design Ltd. · 2026-09
Faire corriger les copies de plusieurs IA entre elles est désormais une pratique courante. Mais une question est rarement posée : qui doit corriger qui ? Nous avons mené une expérience contrôlée — 3 500 problèmes, environ 140 000 appels, deux benchmarks publics — en appariant les mêmes réponses de différentes façons pour une relecture mutuelle. La réponse peut vous faire économiser de l'argent : l'appariement ne change rien. Réunir les deux agents les plus en désaccord n'est pas meilleur qu'un tirage au sort.
Trois résultats
« Le plus différent » n'est pas « le plus instructif »
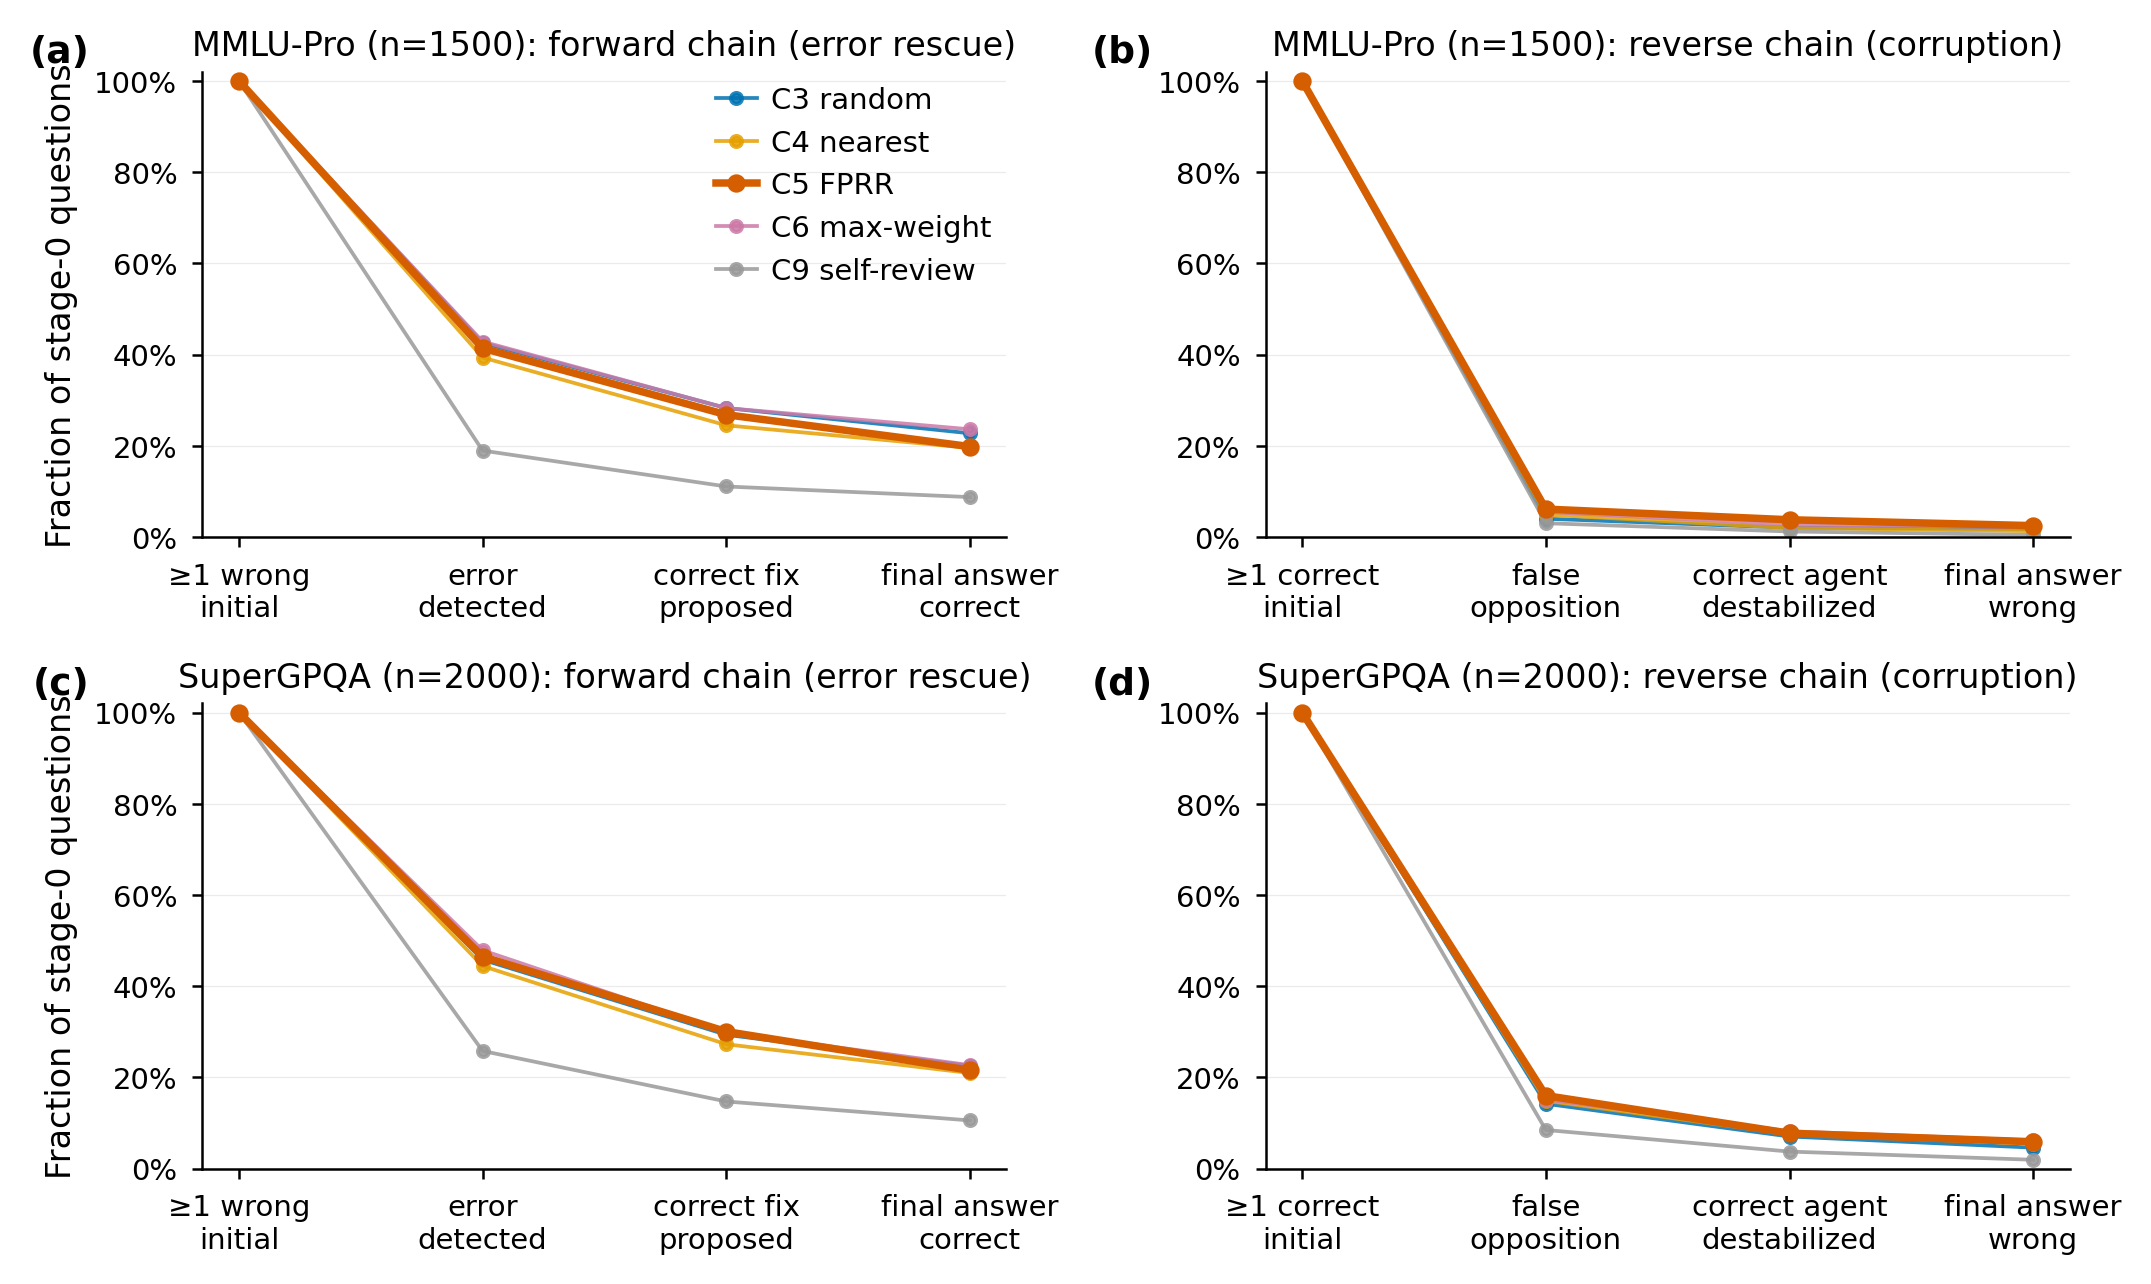
L'appariement le plus distant pousse bien les IA à repérer plus souvent les erreurs de leurs pairs : la détection augmente de façon monotone avec la distance sémantique, avec un ordre de grandeur d'écart entre le premier et le dernier décile. Mais détecter une erreur n'est pas la corriger — une fois l'erreur détectée, la proposition d'un correctif juste et son adoption ne dépendent pas de la distance. Le système est devenu meilleur pour trouver les fautes, pas pour les réparer.
Une relecture active, mais à somme nulle
Chaque erreur corrigée est compensée par une autre réponse, initialement juste, déstabilisée par une « opposition erronée » — les deux directions s'annulent presque exactement. Sur le benchmark le plus difficile, renoncer à la relecture et remettre directement les candidats au synthétiseur donne des résultats significativement meilleurs (+1.5 point, p = 0.010). La relecture n'est pas une étape neutre et gratuite : au mauvais endroit, c'est un coût net.
Le goulot d'étranglement, c'est l'attribution du crédit
Les relecteurs produisent parfois une réponse juste absente des quatre candidats initiaux — une information réellement nouvelle — mais moins de 1.5 % survit jusqu'à la réponse finale. Le système ne distingue pas le désaccord correcteur de l'opposition erronée. Transformer le désaccord en une petite question vérifiable, voilà ce que la prochaine génération de systèmes devra résoudre.
Si vous construisez ces systèmes
Le vote majoritaire suivi d'une synthèse directe égale toutes les topologies de relecture pour un cinquième du coût en tokens. Consacrez l'argent économisé à la calibration et à la vérification, pas aux astuces de routage.
Texte intégral et ressources
- 中文全文
- English full text
- 日本語全文
- Texte intégral français
- Code open source et journal complet des expériences (GitHub)
Citer
@misc{fprr2026,
  title  = {Who Should Review Whom? Response-Conditioned Disassortative Peer Review for Test-Time LLM Reasoning},
  author = {Li, Rui and Sun, Chenglong and Zheng, Xueyan and Liu, Dan},
  year   = {2026},
  month  = sep,
  note   = {Gi (Beijing) Tech Design Ltd.}
}
Et ensuite
La prochaine expérience ne demandera plus qui doit discuter avec qui, mais comment distinguer qui est crédible au sein d'un désaccord : candidats et budget fixés, nous ne ferons varier que la visibilité des réponses candidates pour le vérificateur, afin de tester si l'« aveugle » bloque l'opposition erronée. Le protocole est gelé ; les résultats seront publiés de la même façon.