2026年9月
最遠ペア査読は、制御されたマッチングの下でランダムペアリングを上回らない。
意味距離は誤り検出を高めるが、誤り訂正は高めない。
査読は新規の正解を生成するが、最終回答に届くことは稀である。
より難しいベンチマークでは、査読なし合成が相互査読を上回る。
有益遷移比(BTR)が査読の正味ゼロ効果を定量化する。
キーワード: マルチエージェントシステム;大規模言語モデル;テスト時計算;通信トポロジー;相互査読;負の結果
固定された言語モデルからの反復的な確率推論は、モデルの重みに一切手を加えることなく回答精度を大幅に改善できる。独立サンプルに対する自己整合性投票 [1] とサンプル&投票スケーリング [4] がその代表例である。自然な次の一手は、サンプリングされたインスタンス同士を通信させることである。マルチエージェント討論 [2] や相互査読スキーム [25] は、集約の前にモデルのインスタンスが互いの回答を批評し合うことを可能にする。
しかし、同質エージェント間の通信には構造的な弱点がある。同一チェックポイントのインスタンスは、同一プロンプトを与えられると、独立に誤るわけではない。訓練データ・帰納バイアス・失敗様式を共有するため、それらのサンプルは相関する推論クラスター——仮定・戦略・誤解を共有する回答群——を形成する。ブロードキャスト型の通信は多数派の見解を強化する傾向があり、それはまさに共有された誤りを最も体現しやすい見解である。経験的に、討論は単純な多数決を上回らないことが多く [6, 7]、メッセージを剪定または保持する多様性考慮型の変種も、依然としてブロードキャストで通信している [5, 10]。
本論文は、我々の知る限り実験的に単離されたことのない問いを提起する。
誰が誰を査読すべきか? 同一モデルからの \(N\) 個の独立した回答が与えられたとき、ペアワイズ相互査読のトポロジー——具体的には、各エージェントを意味的に最も異なる相手とペアにすること——は、同一のモデル・プロンプト・推論予算の下で、ランダムペアリング・類似度ベースのペアリング・討論・多数決よりも多くの正解を引き出せるか?
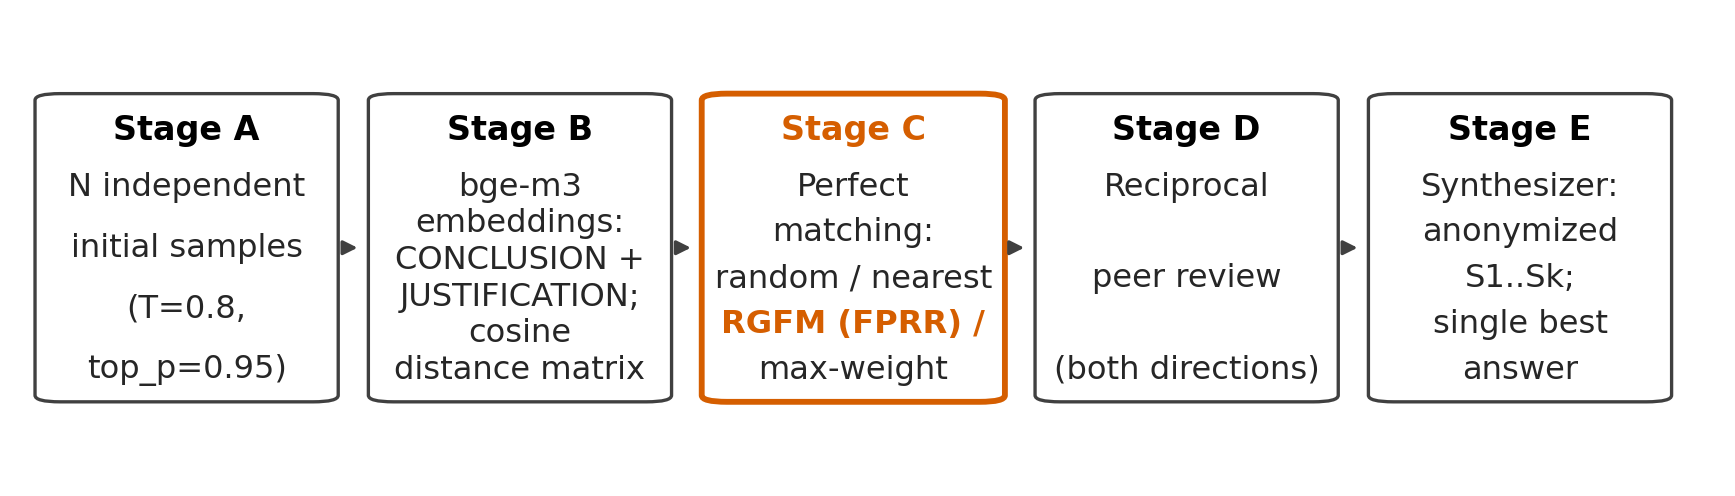
我々はこの問いを最遠ペア相互査読(FPRR)として具体化する。各応答(結論+簡潔な正当化)を埋め込み、ペアワイズのコサイン距離行列を計算し、遠い応答同士をペアにする完全マッチングを構成し(乱択貪欲最遠マッチング、RGFM。変種として厳密な最大重みマッチングを用いる)、各ペア内で相互のペア限定査読を実行し、すべての回答と査読から最終回答を合成する。このパイプラインは学習不要・検索不要であり、全体を通じて1つの凍結モデルと1つの凍結プロンプトセットのみを使用する。
重要な点として、本設計はルーティング規則の因果的寄与を単離する。すべてのペアリング条件はまったく同一のキャッシュ済み初期応答を消費するため、差異を再サンプリングの偶然に帰因させることはできない。また、計算量整合の自己査読コントロールにより、トポロジー効果と単なる推論量の増加とを切り分ける。
応答条件付き査読トポロジーを定式化し、非相称型(最遠ペア)相互査読の初の制御研究を提供する。同一応答集合上での厳密最大重みマッチング・乱択貪欲マッチング・最近接ペアリング・ランダムペアリングを含む。
メカニズム分解を伴う事前登録済みの null 結果(不有意な結果):同一応答集合上で、最遠ペア査読は両ベンチマークにおいて、ランダムペアリング・最近接ペアリング・厳密最大重みマッチング・多数決・計算量整合自己査読と \(\pm 1\) パーセントポイント以内で一致する一方、ペア距離は誤り検出を単調に予測するが、誤り訂正は予測しない。
非相称エッジを横断する情報のメカニズム分析:段階別の検出・修正・採用回帰、順方向対逆方向の査読ファネル、ペア構成効果、遷移ベースの有益遷移比、定量化された失敗様式(有効な選択肢の不安定化・共有された誤解・判定者の失敗)を含む。
完全にログ記録されたキャッシュ応答実験パイプライン(シード付きペアリング・決定論的パース・ペアブートストラップ統計)であり、ルーティング規則を再サンプリングの偶然から単離し、エンドツーエンドで再現可能である。
自己整合性 [1] は多様な思考連鎖を多数決で集約する。Li ら [4] は、多数決のみでエージェント数に応じて精度がスケールすることを示した(彼らの類似度指標は最も類似したサンプルを選択する——我々とは逆の極性である)。単一エージェントの推論トレースプールに対する埋め込み類似度剪定(Slim-SC [29]、SSDP [30]、DeepPrune [31])は効率を改善するが、エージェント間通信は構築しない。DIVSE [32] はプロンプトレベルで多様化する。いずれも応答レベルの距離に通信トポロジーを条件付けてはいない。
Du ら [2] は同質インスタンス間のブロードキャスト討論を確立した。ReConcile [3] は異種モデルと信頼度重み付きコンセンサスを用いる。制御された追試はこれらの主張を和らげる。討論の利益は条件的であり、しばしば自己エージェントのベースラインと同程度にとどまり [6]、多数決が討論を支配しうる [7]。そして制御された論理タスクではエージェントの討論行動そのものが疑問視されている [8]。いずれもブロードキャストまたは固定トポロジーを用いている。
Estornell & Liu [5] は応答埋め込みとペアワイズ距離を計算し、エコーチェンバーを診断し、最大多様性の部分集合へ剪定する——しかし生き残った要素は依然としてブロードキャストであり、ペアリングも相互査読も存在しない。DAR [10] は LLM フィルターを介して不一致の部分集合をブロードキャスト用に保持する(埋め込みは評価指標としてのみ登場する)。Demystifying MAD [9] はユニーク回答数の最大化によりプールを初期化し、GRPO で信頼度を学習する。S\(^2\)-MAD [11] は逆極性の応答コサイン類似度を用いる(冗長な類似視点を抑制する)。RMoA [12] は応答の最遠点式選択を集約入力として行うのであり、査読相手としてではない。この文献系における多様性は、剪定・重み付け・保持・初期化を行うのであり、一対一の査読グラフを構築することは決してない。
我々に最も近い研究である CortexDebate [13] は、疎な討論グラフのエッジ重みに出力コサイン非類似度を含めている(信頼度式の合成・異種モデル・閾値付きブロードキャストグラフ・多数決)。DySCo [14] は推論埋め込みのコサイン距離を5つの選択可能なエッジ信号の1つとして挙げ、一方向の上位 \(k\) 件批評を行う。DyTopo [15] は要求・提供記述子の類似度でルーティングする。MACE [16] はバンディットを介して n-gram 多様性にピア選択を条件付ける。学習型トポロジー手法(GPTSwarm [17]、DyLAN [18]、AgentPrune [19]、G-Designer [20]、MacNet [21]、Graph-GRPO [22]、Guided Topology Diffusion [23]、Codebook Agent [24])は、クエリ・役割・学習済み値に条件付けるのであり、現在の応答間の距離には決して条件付けず、通常は学習を要する。
Xu ら [25] は全対全グラフ上で相互査読を実装している。PiCO [26] はエージェントを相互評価のためにペアにするが、ペアはランダムに組まれる(実質的に、我々のランダムペアリングコントロールに相当する)。トーナメント方式 [27] は能力順位でペアを組む。141 研究のサーベイ [28] は 88.7% が静的トポロジーであると報告し、その分類体系のどこにも埋め込み距離ペアリングは存在しない。我々の手法が占める空の交差領域——応答距離 \(\rightarrow\) 最遠完全マッチング \(\rightarrow\) 相互ペア限定査読 \(\rightarrow\) 合成、すべてが同質・同一プロンプトのサンプル上で学習不要——は、我々の新規性ゲートレポート(NOVELTY_GATE.md)に記録されている。同レポートは、40 件以上の論文について方法セクションの全文精読と、[2] の被引用論文 2,235 件にわたる引用スノーボーリングを行ったものである。
各問題 \(x\) に対し、\(N\)(偶数)個の同質エージェント——同一のチェックポイント・システムプロンプト・問題文・デコード設定——が独立に応答 \(r_i = (\text{answer}_i, \text{justification}_i)\)(\(i=1,\dots,N\))を生成する。正当化は簡潔で可視の推論要約であり(隠れた思考連鎖は要求も使用もされない)、独立な確率的サンプリングが多様性の唯一の源泉である。
各応答は、固定された文エンコーダ \(f\)(bge-m3、1024 次元、Ollama ダイジェスト 790764642607)により \(e_i = f(\text{CONCLUSION: answer}_i \mathbin{\Vert} \text{JUSTIFICATION: justification}_i)\) として埋め込まれる。同一の問題文が類似度を支配してしまうため、問題文は埋め込まない。主たる距離はコサイン距離 \(d_{ij} = 1 - \cos(e_i, e_j)\)(指標 D1)である。アブレーション:D2(正当化のみの埋め込み)、D3(ハイブリッド \(\lambda d_{ij} + (1-\lambda)\mathbf{1}[a_i \neq a_j]\)、\(\lambda\) はパイロットのみで調整)、D4(対称化 NLI(自然言語推論)矛盾確率、roberta-large-mnli)。
距離行列 \(d \in \mathbb{R}^{N\times N}\)、シード付き PRNG \(U \gets \{1,\dots,N\}\);\(M \gets \emptyset\) \(i\) を \(U\) から一様に抽出し(シード付き)、\(j \gets \arg\max_{k \in U \setminus \{i\}} d_{ik}\) とする。\(M \gets M \cup \{(i,j)\}\);\(U \gets U \setminus \{i,j\}\) 完全マッチング \(M\)
FPRR は RGFM を用いる(Algorithm [alg:rgfm])。貪欲規則は順序依存であるため、シードを記録する。コントロール:Random(シード付きランダム完全マッチング)、Nearest(\(\arg\min\) に置き換えた同一ループ)、MaxWeight(\((N-1)!!\) 個のマッチングの全数列挙による厳密最大重み完全マッチング \(M^* = \arg\max_M \sum_{(i,j)\in M} d_{ij}\);\(N \le 8\))。
すべてのペア \((i,j) \in M\) について、エージェント \(i\) が \(j\) を査読し、\(j\) が \(i\) を査読する。査読者が見るのは、問題・自身の回答と正当化・相手の回答と正当化のみであり、それ以外は一切見えない。他のエージェントの回答・正解・埋め込み距離・ペアがどう形成されたかの情報も与えられない。査読プロンプト(凍結済み、すべてのペアリング条件で同一)は、査読者に相手を独立に検査し、正しい主張・具体的な誤り・未検証の仮定を列挙し、最後に判定(PEER CORRECT/PEER INCORRECT)と更新された自身の回答で締めくくることを要求する。迎合と反射的な反対の双方に対抗するため、どちらか一方が正しいと仮定することを明示的に禁じる文言になっている。
1 回の合成器呼び出し(同一モデル)は、問題・匿名化された全候補回答(シード付きの問題ごとのシャッフル後に S1…SN とラベル付け)・および査読条件ではすべてのペアワイズ査読を受け取る。正解・条件名・距離・ペアリング情報は一切与えられない。指示内容は次の通りである。繰り返された主張を独立した証拠として数えないこと。議論の質を評価すること。批評を誤りの特定に用いること。正当と判断される場合は正しい少数派の解を回復すること。修辞的な自信は無視すること。同一の合成器プロンプトがすべての査読条件で使用される。
問題あたり、FPRR は \(N\) 回の初期生成 \(+\) \(N\) 回の査読呼び出し \(+\) \(1\) 回の合成呼び出しを要する。計算量整合コントロール(C9)は、同一のキャッシュ済み初期応答に対して、同一予算を \(N\) 回の自己査読 \(+\) \(1\) 回の合成に費やす。
すべてのエージェントと合成器は1つの凍結された提供モデルを使用する。DeepSeek API 経由の deepseek-flash(DeepSeek-V4.1-Flash)で、温度 \(0.8\)、top-\(p\) \(0.95\)、最大トークン数 1500(解答・査読)/ 2500(合成)とし、可視の正当化が唯一の推論成果物となるよう思考モードは無効化した。プロバイダはシードパラメータを公開していない。確率性は経験的に検証した(同一呼び出しの繰り返しで異なる出力が得られた)。モデルは全エージェント・全条件で同質であり、重みの変更はない。
主要ベンチマークとして MMLU-Pro [35](テスト、12,032 項目、CC-BY-4.0)と SuperGPQA [36](26,526 項目、ODC-BY、サンプリング済み)を用いた。GSM8K [37](テスト)は健全性チェックとして用いた(パイロット:単一エージェントで 95% \(\Rightarrow\) 天井飽和のため本実行から除外)。MATH-500 は保留とした。GPQA-Diamond と LiveBench はこの環境からはアクセスできなかった(アクセス制限あり)。SuperGPQA が近年の大学院レベルのベンチマークとしての役割を担う。問題 ID は層化サンプラー(サンプリングシード 42)で固定され、すべての条件とシードで共有される。
C0:単一応答。C1:\(N{=}4\) のキャッシュ済み応答に対する多数決。C2:キャッシュ済み応答 \(\rightarrow\) 合成器(査読なし)。C3/C4/C5/C6:同一のキャッシュ済み応答上で Random / Nearest / RGFM / MaxWeight の各ペアリングによる相互査読。C9:計算量整合の自己査読。C7:1 ラウンドのブロードキャスト討論(パイロットのみ)。すべてのペアリング条件は(問題、シード)ごとに同一の初期応答を消費する。
パイロット:ベンチマークあたり 100 問。本実験:MMLU-Pro は 500 問 \(\times\) 3 実験シード、SuperGPQA は 500 \(\times\) 4 シード。距離指標アブレーション(D2/D3/D4 下の C5、200 問の部分集合、シード 0。各ベンチマーク内で D3/D4 は D2 のキャッシュ済み初期応答を再利用)は、MMLU-Pro D4 を除き完走した。\(N \in \{2,4,6,8\}\) のアブレーションとペアリングシード分散研究(事前登録済み、修正 8)は予算の都合で実行しなかった(§10)。
正解精度は凍結された決定論的パーサーで算出した(最後の FINAL ANSWER: 行。パース不能 \(\Rightarrow\) 不正解)。精度差の 95% 信頼区間にはペアブートストラップ(問題にわたる 10,000 回の再サンプリング)を用い、C5 対 {C3, C4, C1, C9} には連続性補正付き McNemar 検定と Holm–Bonferroni 補正を適用した。仮説 H1–H6 は、本テストの評価に先立ち事前登録された(preregistration.md 参照、すべての修正を含む)。
GSM8K と MATH は古く、露出が激しいため、これらに基づく主張は一切行わない。MMLU-Pro(2024 年 6 月)、とりわけ SuperGPQA(2025 年 1 月)は多くの訓練データより後に登場している。SuperGPQA の大学院レベルの項目と、そこでのモデルの中域精度(パイロットで単一エージェント 61%)により、より感度の高い測定器となる。それでも残留コンタミネーションは限界として扱う。それは絶対値を押し上げうるだけであり、すべての条件に同一に適用されるため、ペア差は解釈可能なままである。
すべての API 呼び出しは JSONL にログ記録される(問題 ID・完全なプロンプト・生出力・パース済みフィールド・トークン使用量・レイテンシ・タイムスタンプ・条件・シード)。初期応答はキャッシュされ条件間で共有される。ペアリング/マッチングの決定は距離のみに依存し、ゴールドラベルには決して依存しない。コードと設定はバージョン管理され(git)、分析スクリプトは決定論的である(シード付きブートストラップ)。
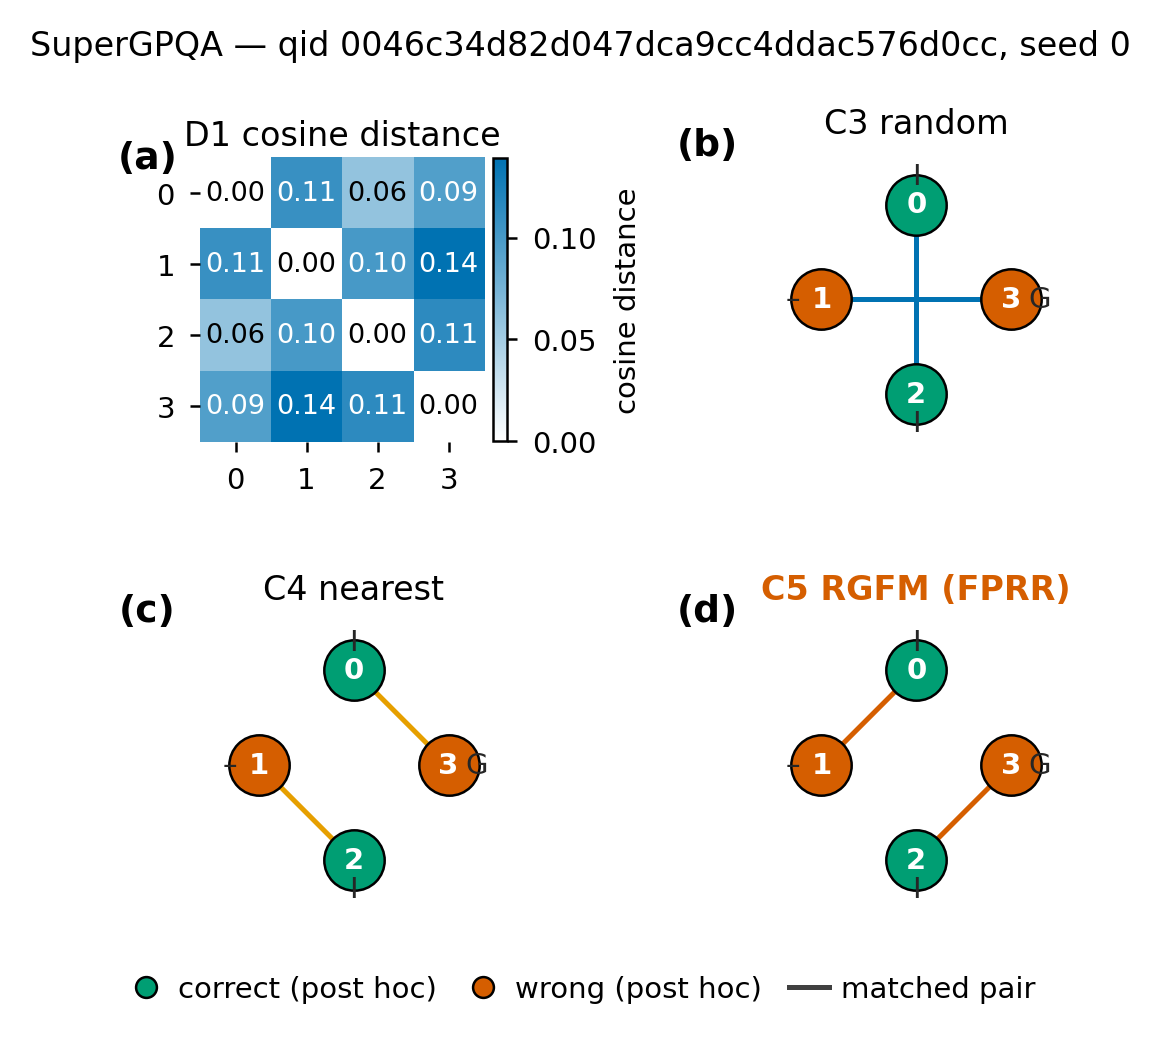
図1はパイプラインの概観である(第3節)。本節全体を通じ、すべてのペアリング条件は(問題、シード)ごとに同一のキャッシュ済み初期応答を消費する。
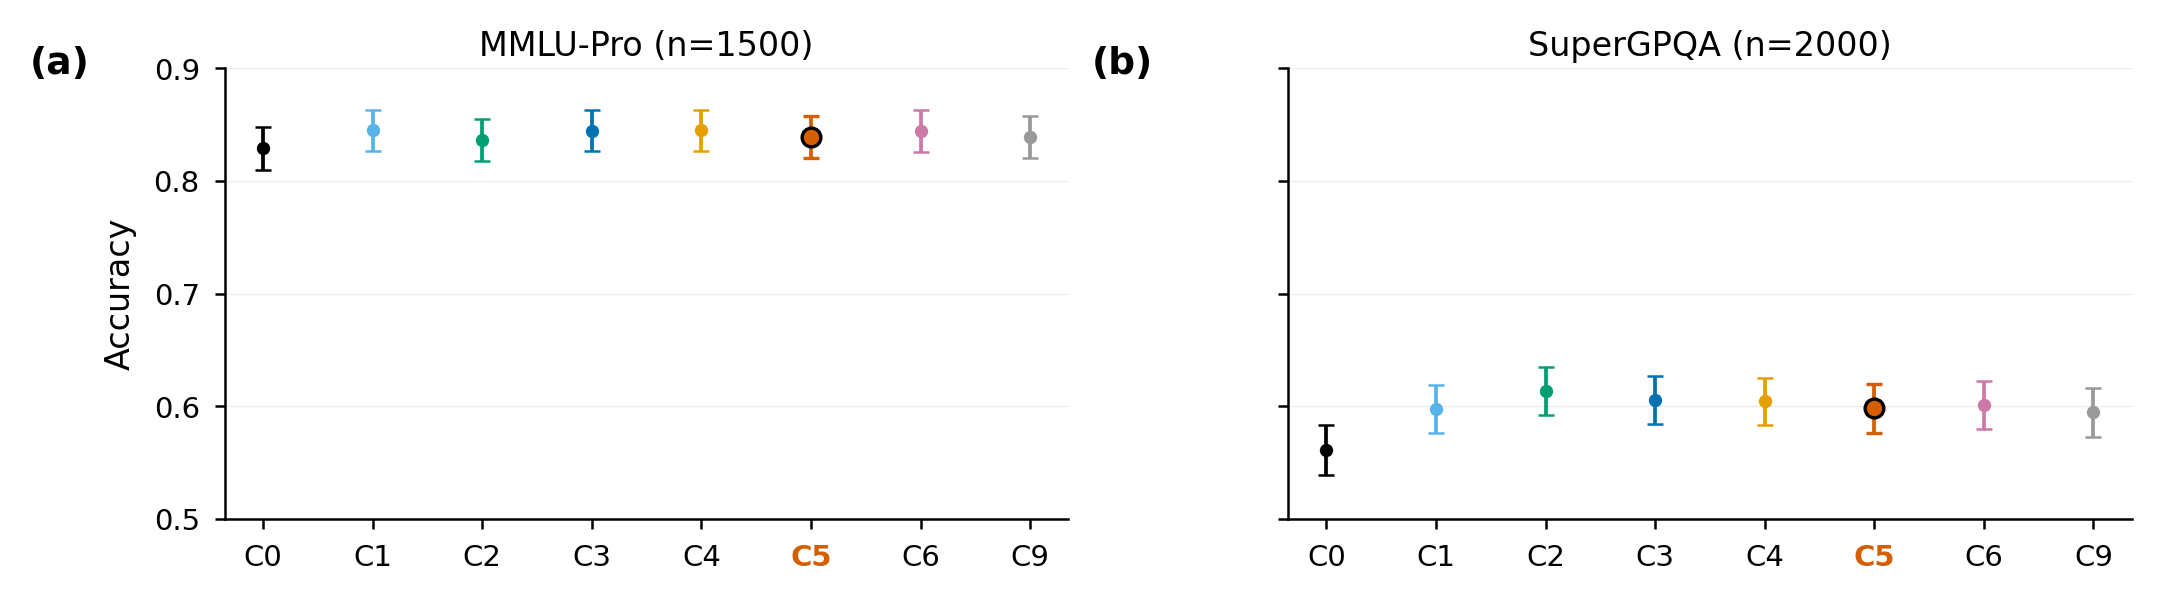
表1は MMLU-Pro における精度を報告する(500 問 \(\times\) 3 実験シード、プール観測数 \(n=1500\))。すべての \(N{=}4\) 集約条件は 0.8pp の帯域(0.837–0.845)内に収まる。FPRR(C5、0.839)は計算量整合自己査読コントロール(C9、0.839)とともにその帯域の下端に位置し、ランダムペアリング・最近接ペアリング・最大重みマッチング・単純多数決(すべて 0.845)より 0.6pp 低い。図2はほぼ同一の精度を可視化したものである。
| 条件 | 名称 | プール精度 | 95% CI | シード別精度 | |
| s0 / s1 | s2 | ||||
| C0 | 単一応答 | 0.829 | [0.810, 0.848] | 0.824 / 0.834 | 0.830 |
| C1 | 多数決 | 0.845 | [0.827, 0.863] | 0.844 / 0.844 | 0.848 |
| C2 | アンサンブル+合成 | 0.837 | [0.818, 0.855] | 0.838 / 0.840 | 0.832 |
| C3 | ランダムペア | 0.845 | [0.827, 0.863] | 0.846 / 0.850 | 0.838 |
| C4 | 最近接ペア | 0.845 | [0.827, 0.863] | 0.842 / 0.846 | 0.848 |
| C5 | FPRR (RGFM) | 0.839 | [0.821, 0.857] | 0.844 / 0.836 | 0.838 |
| C6 | 最大重みマッチング | 0.845 | [0.826, 0.863] | 0.840 / 0.846 | 0.848 |
| C9 | 自己査読(整合) | 0.839 | [0.821, 0.857] | 0.838 / 0.838 | 0.842 |
| 比較 | diff (pp) | 95% CI (pp) | McNemar \(b/c\) | \(p\) | \(p_{\mathrm{Holm}}\) |
|---|---|---|---|---|---|
| C5 対 C3(ランダム) | \(-0.5\) | [\(-1.3\), \(0.2\)] | 13/21 | 0.230 | 0.920 |
| C5 対 C4(最近接) | \(-0.6\) | [\(-1.5\), \(0.3\)] | 19/28 | 0.243 | 0.920 |
| C5 対 C1(多数決) | \(-0.6\) | [\(-1.5\), \(0.3\)] | 18/27 | 0.233 | 0.920 |
| C5 対 C9(自己査読) | \(0.0\) | [\(-0.8\), \(0.8\)] | 19/19 | 0.871 | 0.920 |
| C5 対 C0(単一) | \(+1.0\) | [\(-0.1\), \(2.1\)] | 41/26 | 0.087 | — |
| C5 対 C2(査読なし) | \(+0.3\) | [\(-0.7\), \(1.2\)] | 27/23 | 0.671 | — |
| C5 対 C6(最大重み) | \(-0.5\) | [\(-1.4\), \(0.3\)] | 16/24 | 0.268 | — |
表2はペア分析を示す。すべての一次比較のブートストラップ CI はゼロをまたぎ、4 つの Holm 調整済み \(p\) 値はすべて \(0.920\) であった。すなわち、FPRR とランダムペアリング(H1)・最近接ペアリング(H2)・多数決(H3)・計算量整合自己査読コントロールとの間に検出可能な差はない。単一応答ベースラインに対して FPRR は \(+1.0\)pp の利得を得るが、有意には達しない(\(p=0.087\)、未補正)。
SuperGPQA(500 問 \(\times\) 4 シード、プール \(n=2000\))は、より低い精度で同じパターンを示し、1 つ鋭い結果が加わる(表3)。FPRR(0.599)はランダムペアリング(0.606)・最近接ペアリング(0.605)・最大重みマッチング(0.602)・多数決(0.598)・自己査読(0.595)と区別がつかず、むしろわずかに下回る。4 つの一次比較の Holm 調整済み \(p\) 値はすべて \(\ge 0.987\) であった(表4)。このより難しいベンチマークでは、すべての \(N{=}4\) 条件が単一応答ベースラインを明確に上回る(C0:0.561。C5 対 C0:\(+3.8\)pp、95% CI [\(+2.3\), \(+5.2\)]、\(p<0.001\))ため、アンサンブルの仕組み自体は有効である。しかし査読なし合成条件 C2(0.614)が最良の条件であり、ここでは損失はもはやノイズではない。C2 は C5 を \(1.5\)pp 上回り、ブートストラップ CI はゼロを含まない(\([-2.6, -0.4]\)、McNemar \(p=0.010\)。Holm 補正ファミリー外の二次比較であり、シード間依存の下で反保守的)。より難しいベンチマークでは、相互査読は同一のキャッシュ済み回答を単に合成する場合と比べて、小さいが統計的に検出可能な正味のコストをもたらす。これは §7.4 の遷移分析(BTR \(= 0.383\))と整合する。
| 条件 | 名称 | プール精度 | 95% CI | シード別精度 (s0/s1/s2/s3) |
|---|---|---|---|---|
| C0 | 単一応答 | 0.561 | [0.539, 0.583] | 0.546 / 0.572 / 0.568 / 0.558 |
| C1 | 多数決 | 0.598 | [0.576, 0.619] | 0.594 / 0.604 / 0.588 / 0.604 |
| C2 | アンサンブル+合成 | 0.614 | [0.593, 0.635] | 0.616 / 0.622 / 0.608 / 0.608 |
| C3 | ランダムペア | 0.606 | [0.584, 0.627] | 0.594 / 0.598 / 0.616 / 0.614 |
| C4 | 最近接ペア | 0.605 | [0.583, 0.625] | 0.598 / 0.604 / 0.602 / 0.614 |
| C5 | FPRR (RGFM) | 0.599 | [0.577, 0.620] | 0.598 / 0.602 / 0.596 / 0.598 |
| C6 | 最大重みマッチング | 0.602 | [0.580, 0.623] | 0.594 / 0.606 / 0.608 / 0.598 |
| C9 | 自己査読(整合) | 0.595 | [0.573, 0.616] | 0.602 / 0.586 / 0.588 / 0.604 |
| 比較 | diff (pp) | 95% CI (pp) | McNemar \(b/c\) | \(p\) | \(p_{\mathrm{Holm}}\) |
|---|---|---|---|---|---|
| C5 対 C3(ランダム) | \(-0.7\) | [\(-1.8\), \(+0.4\)] | 56/70 | 0.247 | 0.987 |
| C5 対 C4(最近接) | \(-0.6\) | [\(-1.7\), \(+0.5\)] | 54/66 | 0.315 | 0.987 |
| C5 対 C1(多数決) | \(+0.1\) | [\(-1.1\), \(+1.3\)] | 72/70 | 0.933 | 1.000 |
| C5 対 C9(自己査読) | \(+0.4\) | [\(-0.8\), \(+1.5\)] | 68/61 | 0.597 | 1.000 |
| C5 対 C0(単一) | \(+3.8\) | [\(+2.3\), \(+5.2\)] | 151/76 | \(<\)0.0001 | — |
| C5 対 C2(査読なし) | \(-1.5\) | [\(-2.6\), \(-0.4\)] | 49/79 | 0.010 | — |
| C5 対 C6(最大重み) | \(-0.3\) | [\(-1.4\), \(+0.8\)] | 54/60 | 0.640 | — |
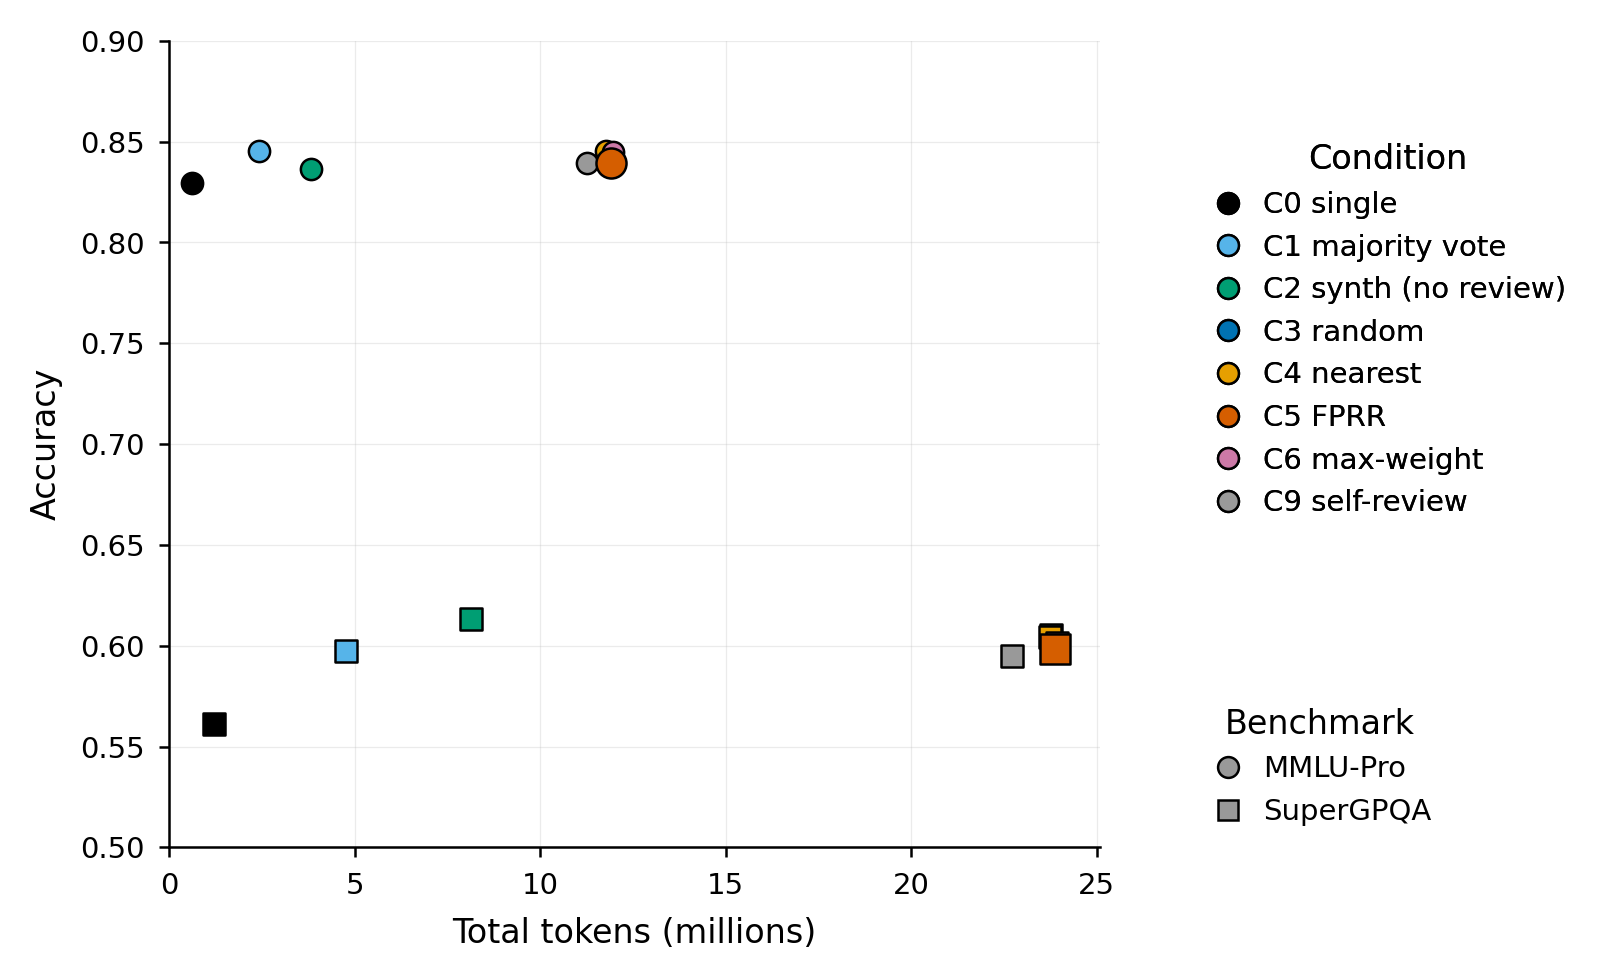
査読は高コストであり、ここでは何ももたらさない(表5、図3)。MMLU-Pro では、C5 は \(11.89\)M トークンを消費する——単一応答ベースラインの \(19.7\times\)、多数決の \(4.9\times\)——でありながら、精度は多数決より 0.6pp 低い。百万トークンあたりの精度は 1.37(C0)・0.35(C1)から、すべての査読条件で 0.07 に低下する。SuperGPQA でもシードあたりほぼ同水準のトークンコスト(C5 は 4 シードで \(23.87\)M)で同じパターンが見られ、さらに査読は査読なし合成に有意に劣後する。
| MMLU-Pro (\(n=1500\)) | SuperGPQA (\(n=2000\)) | |||
| 条件 | トークン (M) | acc/Mtok | トークン (M) | acc/Mtok |
| C0 | 0.60 | 1.37 | 1.20 | 0.47 |
| C1 | 2.41 | 0.35 | 4.76 | 0.13 |
| C2 | 3.82 | 0.22 | 8.14 | 0.08 |
| C3 | 11.80 | 0.07 | 23.77 | 0.03 |
| C4 | 11.78 | 0.07 | 23.74 | 0.03 |
| C5 | 11.89 | 0.07 | 23.87 | 0.03 |
| C6 | 11.95 | 0.07 | 23.92 | 0.03 |
| C9 | 11.26 | 0.07 | 22.71 | 0.03 |
H1(FPRR \(>\) ランダムペアリング):支持されない。MMLU-Pro で \(-0.5\)pp、SuperGPQA で \(-0.7\)pp。両 CI はゼロをまたぐ(\(p_{\mathrm{Holm}} = 0.920\) / \(0.987\))。H2(FPRR \(>\) 最近接ペアリング):支持されない。\(-0.6\)pp / \(-0.6\)pp(\(p_{\mathrm{Holm}} = 0.920\) / \(0.987\))。H3(FPRR \(>\) 多数決):支持されない。\(-0.6\)pp / \(+0.1\)pp(\(p_{\mathrm{Holm}} = 0.920\) / \(1.000\))。厳密最大重みマッチング(C6)は貪欲 RGFM より良い結果とはならず、計算量整合自己査読コントロール(C9)は両ベンチマークで FPRR の精度をほぼ正確に再現する。したがって、この null 結果はマッチングの部分最適性や査読計算量そのものに帰因するものではない。
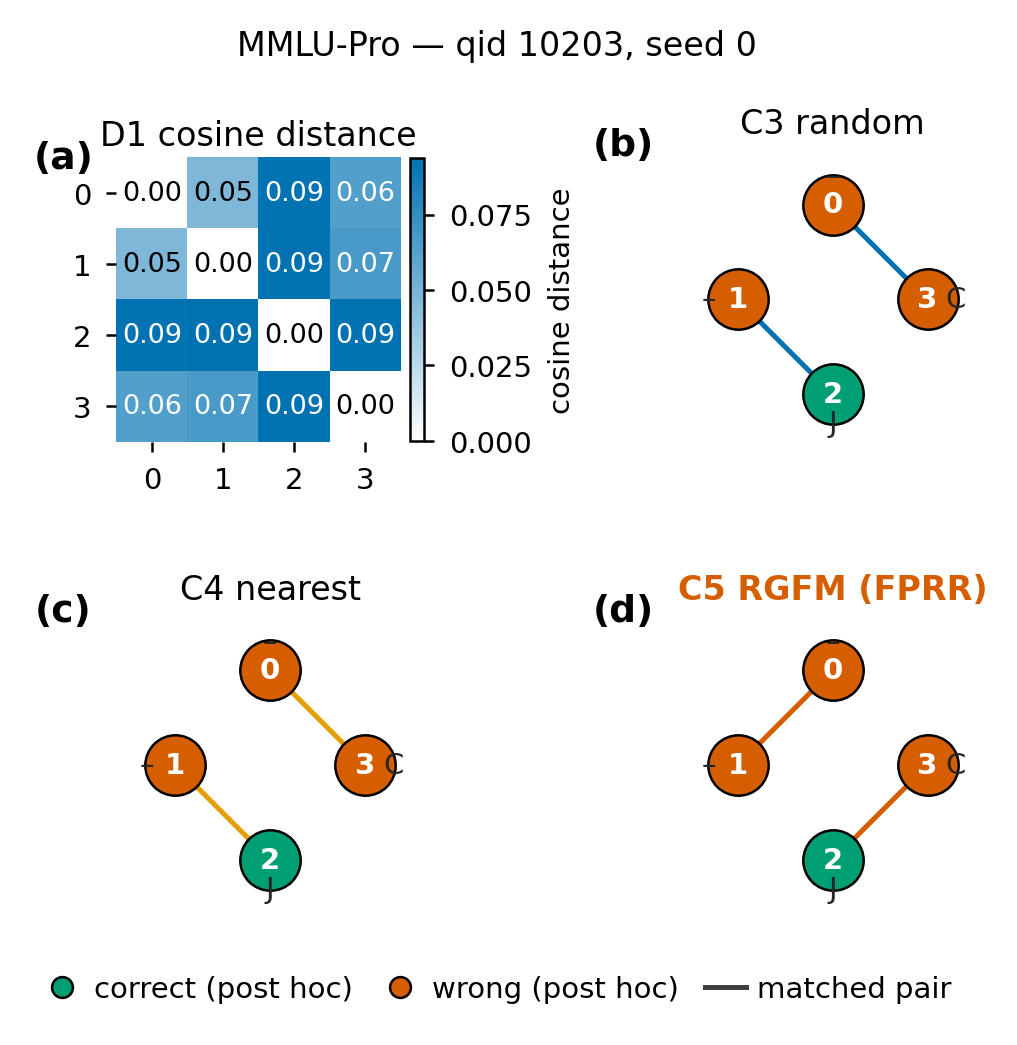
4 つのペアリング条件はすべて同一のキャッシュ済み初期応答を査読するため、それらの間の精度差はマッチングのみに帰因できる。実質的に差は存在しない。MMLU-Pro では C3/C4/C5/C6 が 0.845 / 0.845 / 0.839 / 0.845(幅 0.6pp)、SuperGPQA(\(n=2000\)、4 シード)では 0.606 / 0.605 / 0.599 / 0.602(幅 0.7pp)である。厳密最大重みマッチング(C6)は貪欲 RGFM(C5)と区別がつかず、逆極性である最近接ペアリング(C4)はランダムペアリングと同率である。図5は、4 つの規則が同一の応答をいかに異なって配線するかを可視化する。精度にとって配線は問題にならない。
MMLU-Pro では、査読条件(0.839–0.845)は査読なし合成条件 C2(0.837)から 0.8pp 以内に位置し、C1 多数決(0.845)はごくわずかなコストで最良の査読条件と同率である。SuperGPQA では順序が逆転する。C2(0.614)が最良の条件であり、すべての査読条件(0.599–0.606)を上回り、C1 は 0.598 である。4 シードではこの差は統計的に検出可能である(C5 対 C2:\(-1.5\)pp、95% CI [\(-2.6\), \(-0.4\)]、\(p=0.010\) 未補正。表4)。したがって相互査読は、どちらの集約ベースラインに対しても付加価値をもたらさない——より難しいベンチマークではむしろわずかに減じる。
同一呼び出し予算での自己査読は FPRR をほぼ正確に再現する(MMLU-Pro:0.839 対 0.839。SuperGPQA:0.595 対 0.599。C5 対 C9 の差:\(0.0\)pp / \(+0.4\)pp、\(p_{\mathrm{Holm}} = 0.920\) / \(1.000\))。査読予算を自己批評に費やすことは、相互査読に費やすのとまったく同じだけ良く——そして同じだけ限定的——である。予算は固定されているため、この null 結果はルーティングに帰着する。
事前登録に従い、ハイブリッド距離 D3 の \(\lambda\) は本実行前に \(0.5\) に固定した。これはヘッドルームの大きいベンチマークでのパイロット最良値であり、それ以外では中点である(C5 下のパイロット距離アブレーション、ベンチマークあたり 100 問、シード 0。パイロットデータは調整のみに用い、証拠としては報告しない)。表6は本実験の 200 問距離アブレーションを報告する(D2/D3/D4 下の C5、シード 0。各ベンチマーク内で D3/D4 は D2 のキャッシュ済み初期応答を再利用するため、指標間のペア比較は各指標が誘導するトポロジーを単離する)。この分析は探索的である(事前登録・修正 8:メカニズム的分析、Holm 補正された一次ファミリーの外部)。
SuperGPQA では、不一致感知型の指標が純粋な意味距離を上回った。D4(NLI 矛盾)は \(0.680\) に達し、D2(結論+正当化のコサイン)の \(0.650\) に対して優位である。ペア差 D4 \(-\) D2 は \(+3.0\)pp で、ブートストラップ CI はゼロを含まない(\([+0.5, +6.0]\))——ただし不一致問題はわずか \(7\) 対 \(1\)(McNemar \(p=0.077\))、単一シード、200 問である。この信号は実在するが脆弱であり、再検証を要する。メカニズムは §7 と整合する。D4 では多数派毀損率が D2 に対して 6 分の 1 に低下し(\(0.008\) 対 \(0.048\)。D3:\(0.024\))、訂正率は 3 指標中最高である(\(0.289\) 対 D2 の \(0.268\)。査読レベルの誤反対判定率は \(0.047\)–\(0.052\) で平坦)——NLI 矛盾は埋め込みコサインよりも認識論的対立に近いため、D4 下の最遠ペアリングはより頻繁に「やる価値のある争い」を選ぶ。MMLU-Pro ではすべての指標差が null である(D2/D3 は互いに、また多数決に対しても \(0.5\)pp 以内)。飽和したベンチマークにはルーティング信号の入るヘッドルームがない。MMLU-Pro D4 は未実行である(予算)。
| ベンチマーク | 指標 | C5 精度 | C1 精度 | C5 \(-\) C1 [95% CI], \(p\) | D2 とのペア差 [95% CI], \(p\) |
|---|---|---|---|---|---|
| SuperGPQA | D2(コサイン) | 0.650 [0.585, 0.715] | 0.630 | \(+2.0\) [\(-2.0\), \(+6.0\)], \(0.45\) | — |
| SuperGPQA | D3 \(\lambda{=}0.5\) | 0.670 [0.605, 0.735] | 0.630 | \(+4.0\) [\(+0.5\), \(+7.5\)], \(0.061\) | \(+2.0\) [\(-0.5\), \(+5.0\)], \(0.29\) |
| SuperGPQA | D4(NLI 矛盾) | 0.680 [0.615, 0.745] | 0.630 | \(+5.0\) [\(+2.0\), \(+8.5\)], \(0.009\) | \(+3.0\) [\(+0.5\), \(+6.0\)], \(0.077\) (7:1) |
| MMLU-Pro | D2(コサイン) | 0.860 [0.810, 0.905] | 0.865 | \(-0.5\) [\(-2.5\), \(+1.5\)], NS | — |
| MMLU-Pro | D3 \(\lambda{=}0.5\) | 0.865 [0.815, 0.910] | 0.865 | \(0.0\) [\(-2.5\), \(+3.0\)], NS | \(+0.5\) [\(-1.5\), \(+2.5\)], \(1.0\) |
| MMLU-Pro | D4(NLI 矛盾) | 未実行(予算) | |||
未実行(予算)。\(N \in \{2,6,8\}\) のアブレーションとペアリングシード分散研究(C3/C5 のペアリングシード 1、2、MMLU-Pro の 200 問部分集合)は事前登録(修正 8)で設計・凍結されていたが、残りの API 予算内では実行できなかった。これらを黙って落とすのではなく欠損として報告し、その不在を限界として数える(§10)。
集約的な null 結果は、より鋭い問いを提起する。非相称エッジは何らかの追加信号を運ぶのか、運ぶとすればどこで消えるのか。我々は査読段階を、互いに逆方向に進む2つの連鎖に分解する(図6)。順方向連鎖——問題に少なくとも1つの誤った初期回答がある(E0)、査読者が誤りを検出する(E1)、正しい修正が提案される(E2)、最終回答が正しい(E3)。逆方向連鎖——問題に少なくとも1つの正しい初期回答がある(C0)、査読者が正しい相手に誤って反対する(C1)、正しい査読者が有効な回答を変えたり疑ったりして不安定化する(C2)、最終回答が誤りになる(C3)。
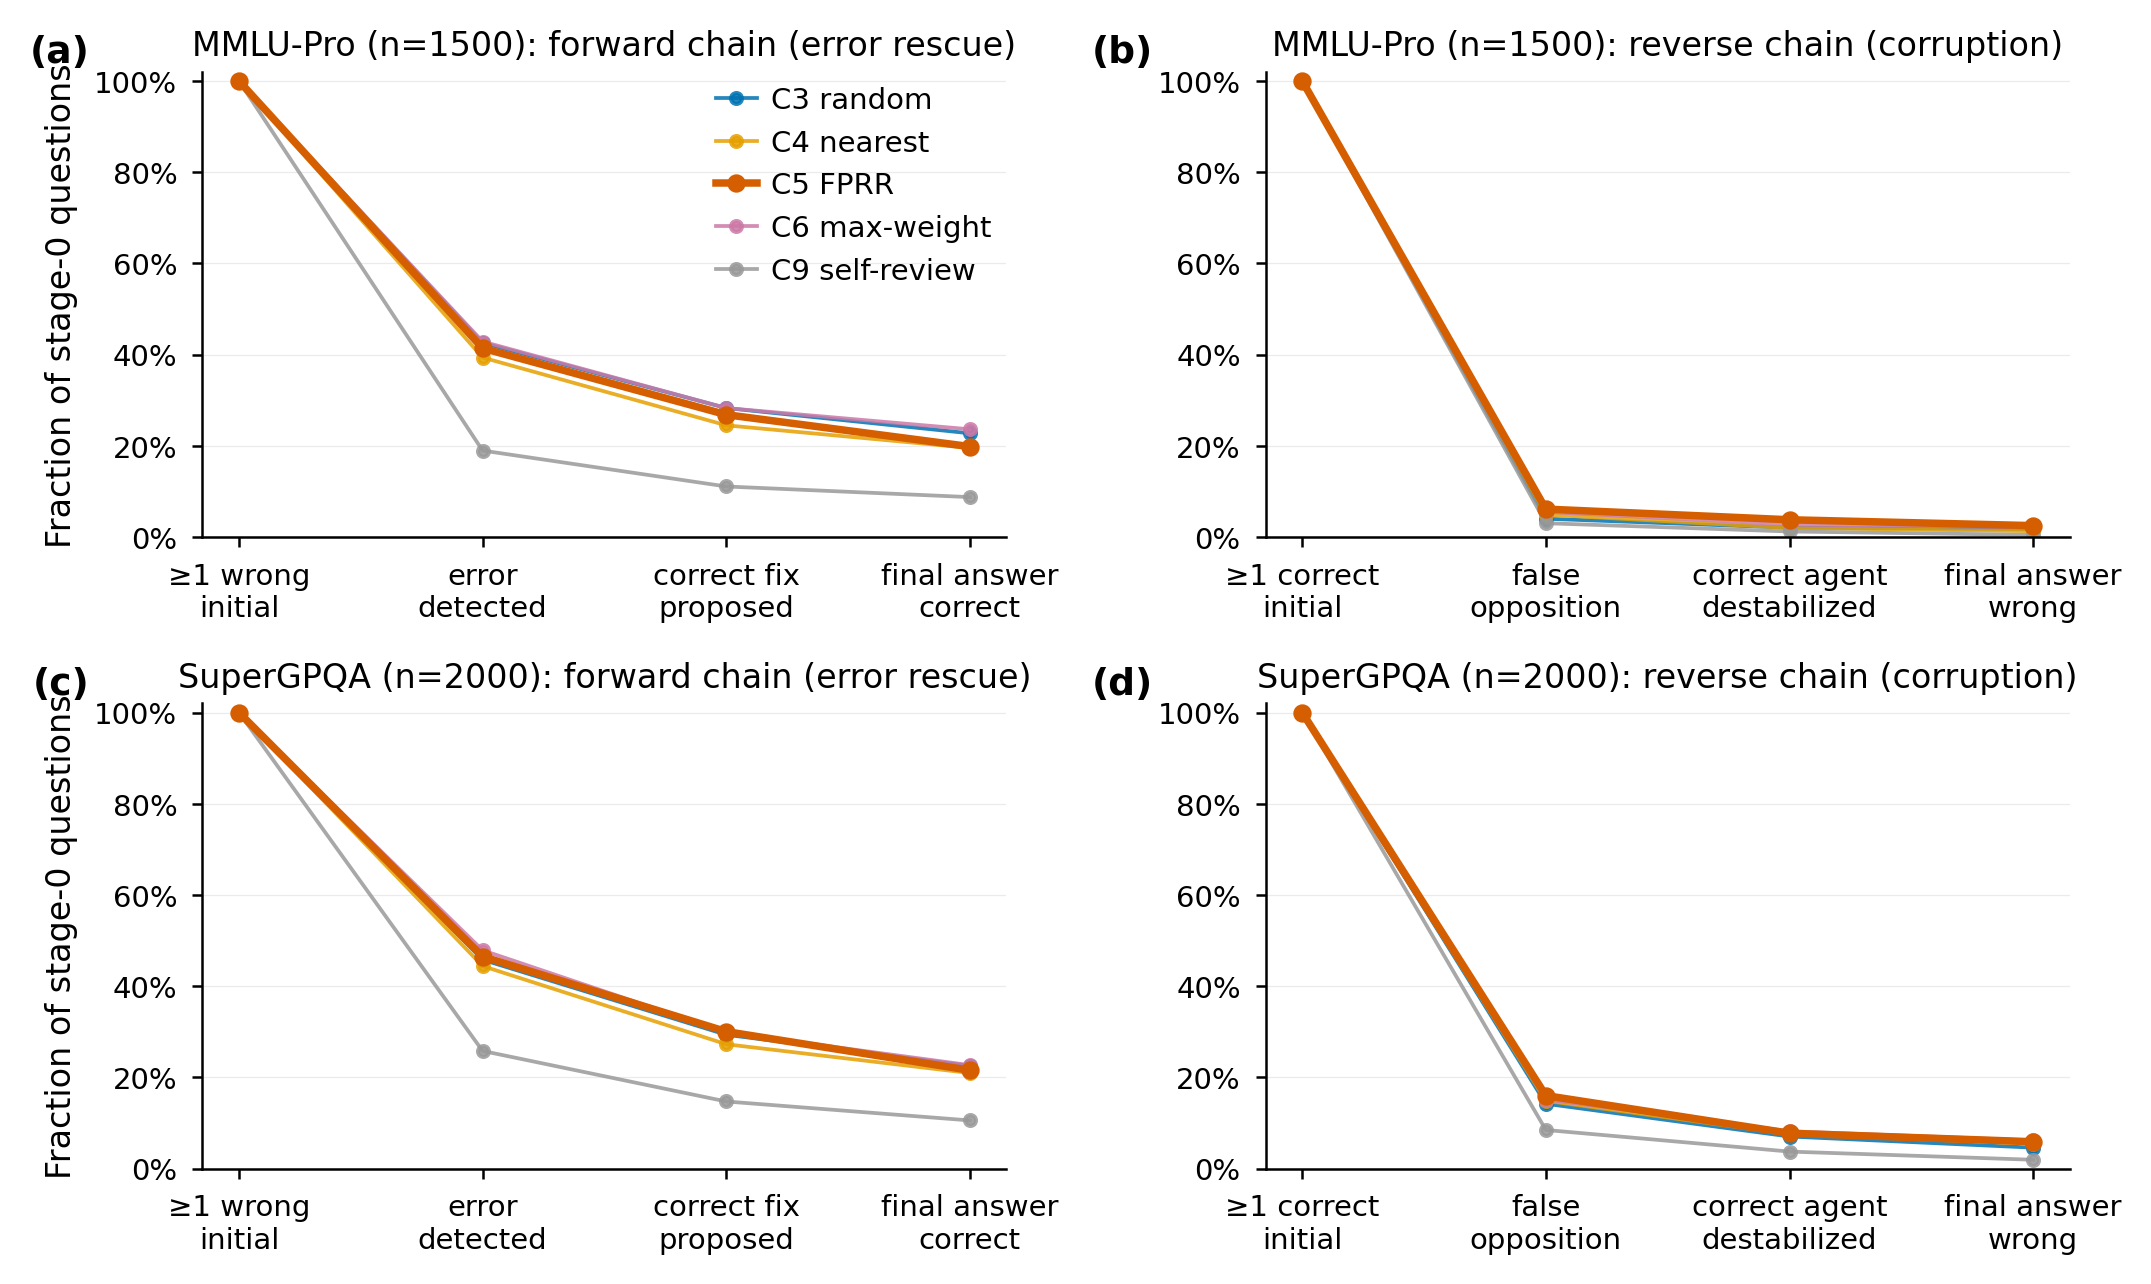
FPRR は確かに、不一致が起こりうるペアへ査読トラフィックを移行させる。方向付き査読を査読者・被査読者の正誤で数えると、C5 は MMLU-Pro の査読の \(412/6000\)(\(6.9\%\))を正誤混合ペアに配置する。ランダムペアリングでは \(328\)(\(5.5\%\))、最近接ペアリングでは \(320\)(\(5.3\%\))であり、誤り横断エッジの相対的増加は \(25\)–\(30\%\) で、厳密最大重みマッチング(C6:\(416\)、\(6.9\%\))と一致する。SuperGPQA では移行はより小さい。C5 は査読の \(1270/8000\)(\(15.9\%\))を混合ペアに配置し、ランダムペアリングの \(1194\)(\(14.9\%\))、最近接ペアリングの \(1098\)(\(13.7\%\))と比較される(C6:\(1330\)、\(16.6\%\))。
表7はすべての C5 査読をペア距離の十分位で層別し、表8は査読レベルの全体的な結果を示す。検出は両ベンチマークおよび 4 つすべてのペアリング規則の下で距離とともに急峻に上昇するが、軽微な局所的非単調性がある(図8)。C5 では、P(判定 INCORRECT \(\mid\) 被査読者が誤り) は最下位十分位から最上位十分位までに MMLU-Pro で \(0.000\) から \(0.379\) へ、SuperGPQA で \(0.050\) から \(0.361\) へ上昇する。C3–C6 全体で最上位十分位の検出率は \(0.368\)–\(0.436\)(MMLU-Pro)、\(0.301\)–\(0.361\)(SuperGPQA)に及ぶ。相互査読は自己査読よりもはるかに頻繁に誤答を検出する(C9:\(0.091\) / \(0.135\)、C3–C6 では \(0.19\)–\(0.26\))。なお、MMLU-Pro で最高の検出率(\(0.227\))を達成するのは C5 ではなく C6 であるが、精度では C3/C4 と同率である。ランダムベースラインを超える追加の検出は、どのルーティング規則の下でも集約的な見返りを持たない。
| MMLU-Pro (6000 件の査読) | SuperGPQA (8000 件の査読) | |||||||
| 十分位 | 距離範囲 | det | cor | f.o. | 距離範囲 | det | cor | f.o. |
| 1 | [0.000, 0.028] | 0.000 | 0.000 | 0.002 | [0.000, 0.034] | 0.050 | 0.021 | 0.027 |
| 2 | [0.028, 0.043] | 0.073 | 0.018 | 0.002 | [0.034, 0.051] | 0.083 | 0.026 | 0.018 |
| 3 | [0.043, 0.056] | 0.089 | 0.051 | 0.006 | [0.051, 0.066] | 0.178 | 0.079 | 0.030 |
| 4 | [0.056, 0.069] | 0.089 | 0.013 | 0.009 | [0.066, 0.078] | 0.233 | 0.123 | 0.039 |
| 5 | [0.069, 0.081] | 0.105 | 0.058 | 0.016 | [0.078, 0.090] | 0.229 | 0.139 | 0.079 |
| 6 | [0.081, 0.094] | 0.200 | 0.130 | 0.023 | [0.090, 0.104] | 0.258 | 0.129 | 0.065 |
| 7 | [0.094, 0.111] | 0.156 | 0.094 | 0.013 | [0.104, 0.119] | 0.279 | 0.155 | 0.072 |
| 8 | [0.111, 0.130] | 0.236 | 0.127 | 0.030 | [0.119, 0.138] | 0.262 | 0.139 | 0.100 |
| 9 | [0.130, 0.161] | 0.256 | 0.103 | 0.043 | [0.138, 0.168] | 0.268 | 0.151 | 0.090 |
| 10 | [0.161, 1.000] | 0.379 | 0.209 | 0.051 | [0.168, 1.000] | 0.361 | 0.171 | 0.097 |
| MMLU-Pro | SuperGPQA (4 シード) | |||||
| 条件 | \(n\) 件の査読 | det | f.o. | \(n\) 件の査読 | det | f.o. |
| C3 ランダム | 5928 | 0.202 | 0.012 | 7561 | 0.241 | 0.054 |
| C4 最近接 | 5918 | 0.192 | 0.016 | 7568 | 0.231 | 0.057 |
| C5 FPRR | 5912 | 0.212 | 0.020 | 7570 | 0.256 | 0.063 |
| C6 最大重み | 5902 | 0.227 | 0.018 | 7561 | 0.254 | 0.062 |
| C9 自己査読 | 5943 | 0.091 | 0.009 | 7668 | 0.135 | 0.037 |
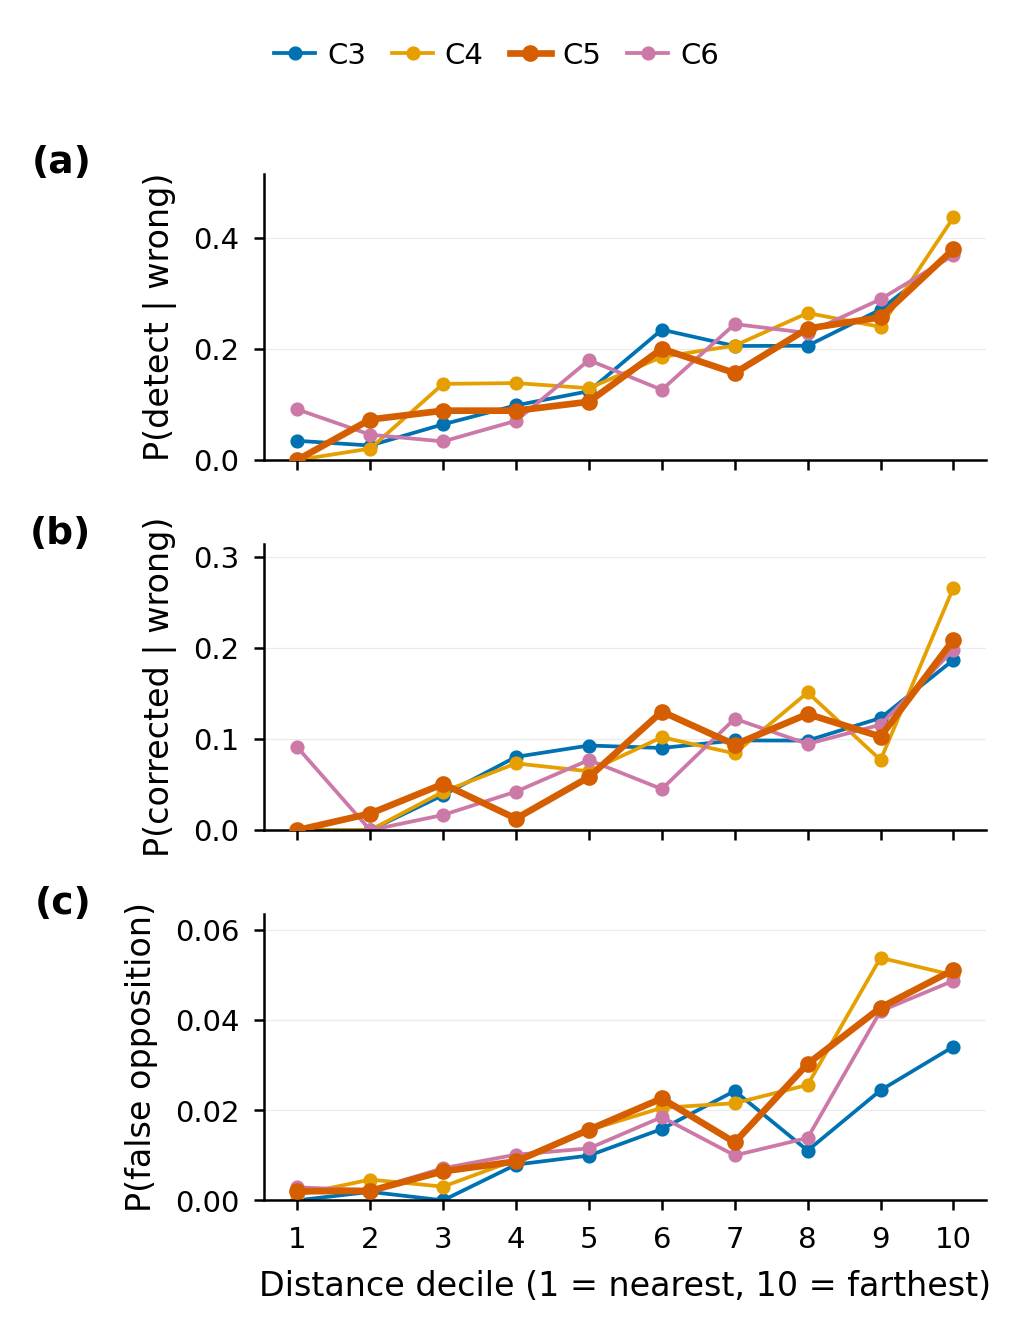
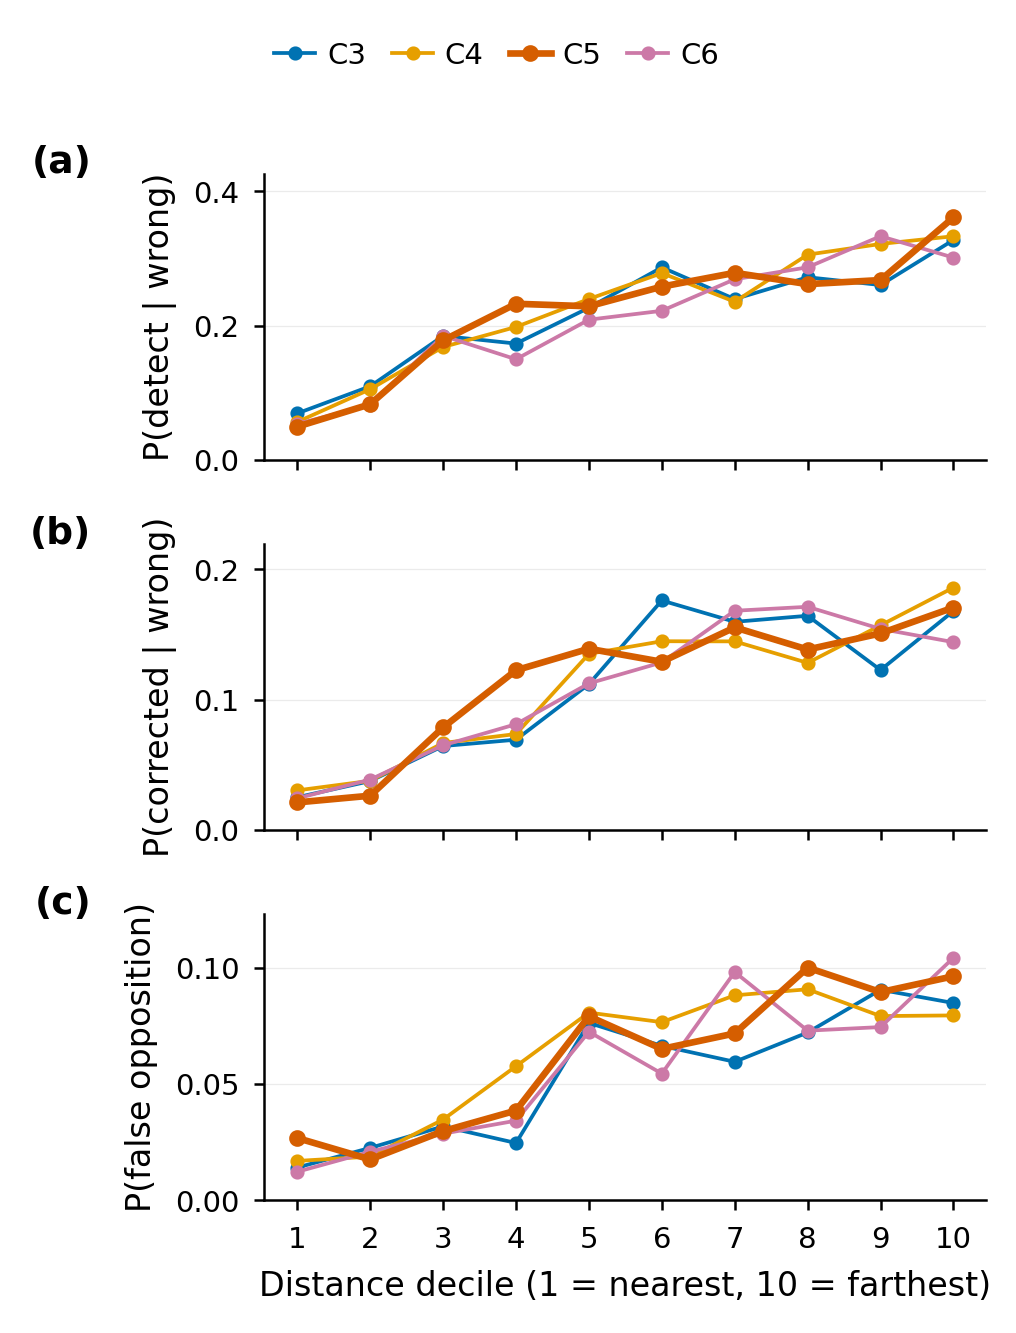
距離がどこで作用するかを特定するため、ペア距離に対して3つのロジスティック回帰をあてはめた(C3–C6 の査読をプール)。誤った被査読者の検出、検出を条件とした正しい修正、修正の存在を条件とした最終正解である(表9)。MMLU-Pro では検出段階のみが距離感受性を持つ(\(\beta = +12.2\)、\(p<0.0001\))。修正への伝播(\(p=0.20\))と採用への伝播(\(p=0.84\))は平坦である。SuperGPQA では3段階すべてが有意である(\(\beta = +7.5\)、\(+1.7\)、\(+7.3\)。それぞれ \(p<0.0001\)、\(p=0.016\)、\(p<0.0001\))——ここでは距離は解決まで伝播する——にもかかわらず、逆方向連鎖(§7.3)が同じ距離でスケールするため、集約精度はやはり動かない。したがって正確な記述はこうなる。距離は誤りへの曝露を改善する。曝露が解決に伝播するかどうかはレジーム依存である。
| ベンチマーク | 段階(アウトカム) | \(n\) | \(\beta_{\mathrm{dist}}\) (SE) | \(p\) |
|---|---|---|---|---|
| MMLU-Pro | P(検出 \(\mid\) 被査読者が誤り) | 4040 | \(+12.20\) (0.75) | \(<0.0001\) |
| MMLU-Pro | P(正しい修正 \(\mid\) 検出済み) | 796 | \(+1.64\) (1.29) | \(0.203\) |
| MMLU-Pro | P(最終正解 \(\mid\) 修正が存在) | 321 | \(-0.52\) (2.66) | \(0.844\) |
| SuperGPQA | P(検出 \(\mid\) 被査読者が誤り) | 14124 | \(+7.54\) (0.37) | \(<0.0001\) |
| SuperGPQA | P(正しい修正 \(\mid\) 検出済み) | 3161 | \(+1.68\) (0.70) | \(0.016\) |
| SuperGPQA | P(最終正解 \(\mid\) 修正が存在) | 1224 | \(+7.30\) (1.52) | \(<0.0001\) |
初期応答選択オラクル——4つのキャッシュ済み初期回答から常に最良のものを選ぶ仮想的存在——は、MMLU-Pro で \(0.883\)、SuperGPQA で \(0.697\) を記録する。最良の実条件である \(0.845\) と \(0.614\) と比較して(ギャップは \({\approx}3.7\)pp と \(8.3\)pp。丸め前の値 \(0.8827\) 対 \(0.8453\)、\(0.6965\) 対 \(0.614\) から算出。丸め後の表の値では \(3.8\)pp を示唆する)。並行研究ははるかに大規模に同じ診断に到達している。15,336 問・81,390 の固定候補プールにわたり、Ji ら [41] は、正解が候補集合内に頻繁に存在しながら選択されないこと、判定者の信頼性がタスク・生成器・正解の稀少性によって変動することを示した。我々の選択オラクルギャップは、完全に制御された同一応答集合の下でこの候補供給ボトルネックを確認し、査読が候補プールを超えて何を加えるかを測定することでこれを拡張する。しかしこのオラクルは熟議システムの天井ではない。査読者は初期集合 \(R_x\) に存在しない回答を生成しうるからである。実際に生成している。4つの初期回答がすべて誤りの問題(MMLU-Pro:176/1500、\(11.7\%\)。SuperGPQA:607/2000、\(30.4\%\))において、査読は \(R_x\) の外の正解を、全条件にわたり \(0\)–\(2.3\%\)(MMLU-Pro)・\(3.1\)–\(4.1\%\)(SuperGPQA)のケースで生成した。査読段階の出力は経験的に初期回答のみの関数ではない。
しかし、この新しい情報が消えるのはデリバリーの地点である(表10)。エンドツーエンドで、新規の正解提案が最終回答に到達したのは、MMLU-Pro の C5 で \(1/176\) 問(\(0.6\%\))、SuperGPQA では最大でも \(9/607\)(\(1.5\%\)、C9。C5:\(8/607 = 1.3\%\))であった。「提案されたが届かず」列がこの損失を定量化する。例えば、C3 は MMLU-Pro で \(4\) 件の新規正解を提案しながら 1 件も届けず、C5 は SuperGPQA で \(25\) 件を提案しながら \(6\) 件のみ採用した(\(19\) 件喪失)。全員一致で誤りの部分集合(120 問と 401 問)内では、すべての条件で最終回答が少なくとも \(99.2\%\)(MMLU-Pro)・\(98.0\%\)(SuperGPQA)のケースで誤りのままである。査読は欠けた回答を創り出せるが、パイプラインはそれを認識できない。
| MMLU-Pro | SuperGPQA (4 シード) | |||||||
| 条件 | 新規提案 | 最終正解 | 採用 | 提案・未達 | 新規提案 | 最終正解 | 採用 | 提案・未達 |
| C3 | 4 | 0 | 0 | 4 | 21 | 8 | 7 | 14 |
| C4 | 3 | 0 | 0 | 3 | 20 | 8 | 6 | 14 |
| C5 | 2 | 1 | 1 | 1 | 25 | 8 | 6 | 19 |
| C6 | 0 | 0 | 0 | 0 | 19 | 7 | 6 | 13 |
| C9 | 1 | 0 | 0 | 1 | 21 | 9 | 8 | 13 |
正しい多数派の毀損に対するパイロット時期の作業仮説は外れ値増幅であった。すなわち、最遠ペアリングは唯一の誤った外れ値を正しいエージェントに優先的に配線する、というものである。本データはこれを集約メカニズムとして棄却する。3:1 の回答分裂内で——同一の分裂構造を持つ問題のみを比較することで問題難度を制御すると——少数単独票が正しい確率は確かに多数派よりはるかに低い(MMLU-Pro:\(20.8\%\) 対 \(57.6\%\)。SuperGPQA:\(28.4\%\) 対 \(44.7\%\))。遠くて珍しい回答は不均衡に誤っている。しかし各問題の最大距離エッジの端点は本質的にベースレートで誤る(最小距離エッジの \(16.3\%\) に対し \(17.1\%\)、ベースレート \(16.8\%\)、MMLU-Pro。\(44.7\%\) 対 \(43.6\%\)、ベース \(44.1\%\)、SuperGPQA)。最遠ペアリングは系統的に誤った相手を選ぶわけではない。したがって我々は外れ値増幅を集約的説明として退かせる。3:1 の結果は「外れ値回答は精度が低い」としてのみ成り立ち、「FPRR が悪い相手を選ぶ」とはならない。
逆方向連鎖が代わりに示すのは、誤反対と有効な回答の不安定化である。誤反対はペア距離とともに上昇する(表7:MMLU-Pro の C5 で \(0.002\) から \(0.051\) へ。SuperGPQA の最大重みペアリングでは最大 \(0.104\))。問題レベルでは(図6、C 側)、MMLU-Pro で正しい査読者の不安定化は C3 より C5 で重い(\(50/1324 = 4\%\) 対 \(27/1324 = 2\%\)。最終誤答は \(33\) 対 \(23\))——C5 は MMLU-Pro の逆方向ファネルの頂点に位置する——一方、SuperGPQA では逆方向連鎖はすべての査読条件で重い(\(0.07\)–\(0.08\) が不安定化)。意味的非類似性は誤った相手へルーティングするのではなく、正しい相手への反対を製造する。
事前登録された二次指標(表11)とコンセンサス遷移(図10)は、結果として生じる収支を定量化する。査読条件は多数決よりも頻繁に多数派の誤りを回復する——しかし MMLU-Pro で名目上最良なのは FPRR ではなくランダムペアリングである(回復 \(0.099\)、救出 \(0.082\))。SuperGPQA では査読なし合成 C2(\(0.099\) / \(0.100\))が、査読を一切行わずに最良の査読条件(C4:\(0.098\) / \(0.106\))に匹敵し、C5 は C9 を除けば最弱の査読条件である(\(0.089\) / \(0.096\))。エージェント 0 の初期回答を基準にすると、MMLU-Pro の査読条件は初期誤答の \(15.2\)–\(18.0\%\) を正解に転じる一方、初期正解の \(1.5\)–\(2.1\%\) を毀損する(C5:\(16.0\%\) / \(2.1\%\)。C1 多数決:\(11.7\%\) / \(0.5\%\))。SuperGPQA ではトレードオフはほぼ対称である(C5:\(17.2\%\) 対 \(6.8\%\))——これこそが、より難しいベンチマークで正味の利得が現れない理由そのものである。
| MMLU-Pro | SuperGPQA (4 シード) | |||||
| 条件 | rec | cor | res | rec | cor | res |
| C0 | 0.026 | 0.024 | 0.032 | 0.048 | 0.094 | 0.064 |
| C2 | 0.065 | 0.022 | 0.050 | 0.099 | 0.040 | 0.100 |
| C3 | 0.099 | 0.019 | 0.082 | 0.096 | 0.051 | 0.100 |
| C4 | 0.086 | 0.016 | 0.059 | 0.098 | 0.054 | 0.106 |
| C5 | 0.078 | 0.021 | 0.059 | 0.089 | 0.059 | 0.096 |
| C6 | 0.086 | 0.017 | 0.064 | 0.096 | 0.058 | 0.099 |
| C9 | 0.065 | 0.019 | 0.036 | 0.070 | 0.051 | 0.075 |
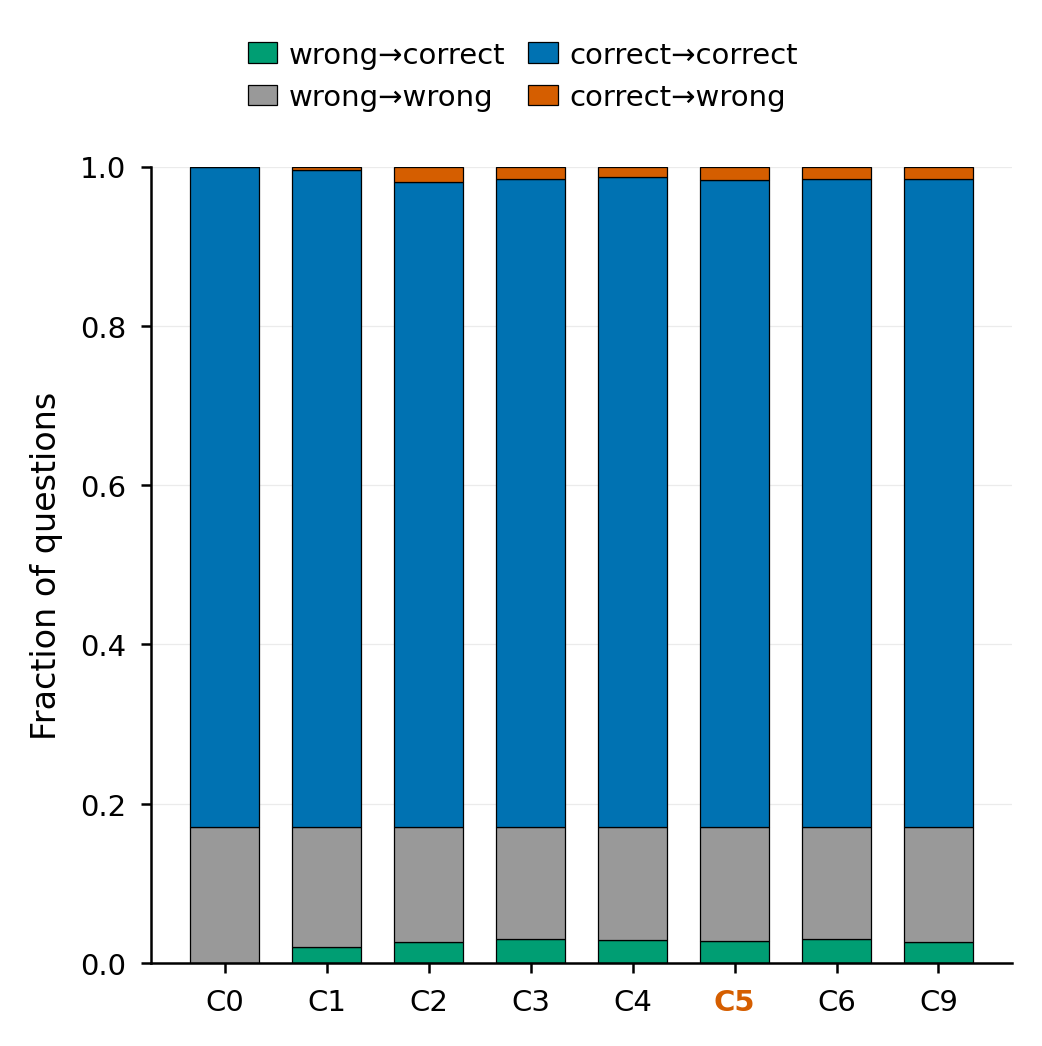
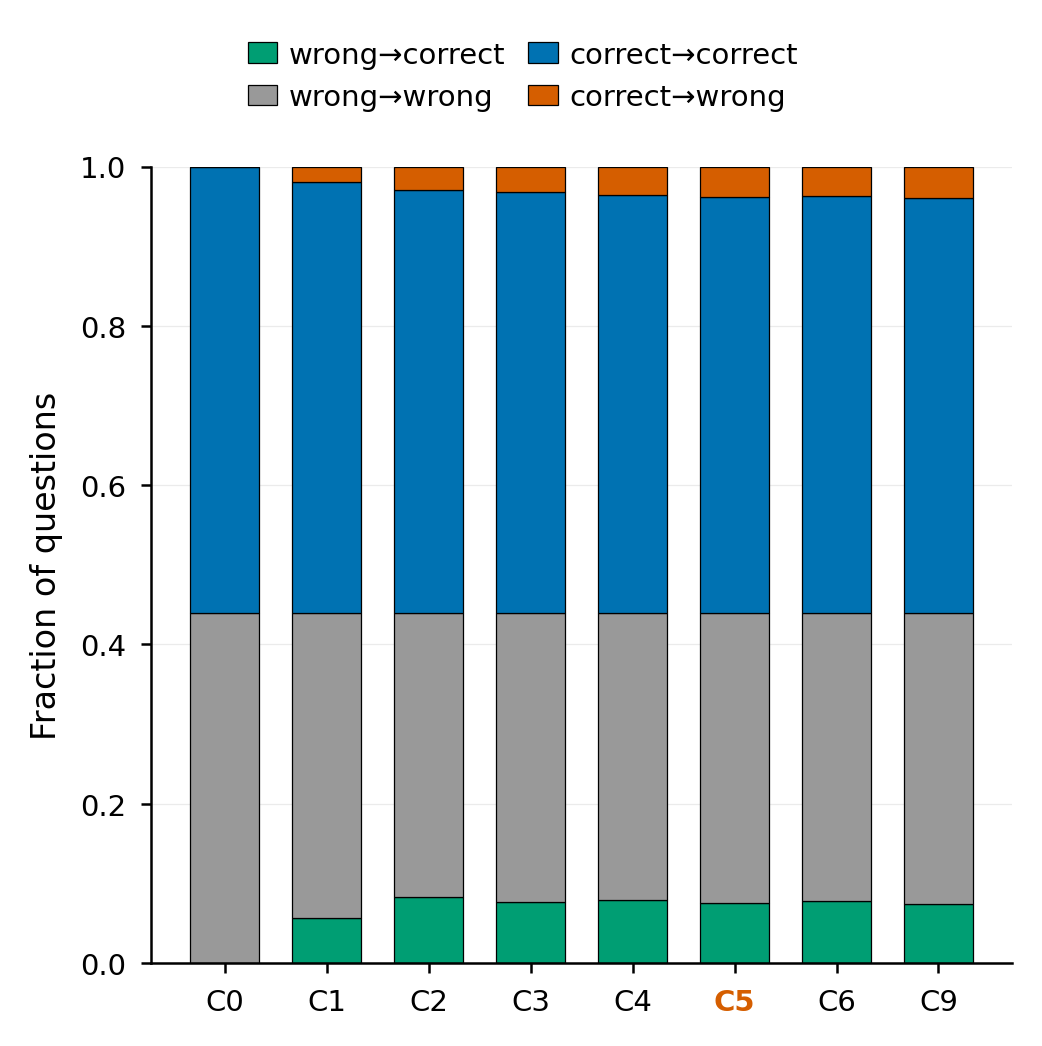
C5 が精度で自己査読コントロール C9 と同率であることは、査読が冗長であることを意味しうる——あるいは、両方向に活動的で相殺されていることを意味しうる。C2\(\leftrightarrow\)C5 の問題レベル遷移がこれを決着させる。同一の合成パイプラインに査読を加えると、MMLU-Pro では \(27\) 問が誤答から正解へ、\(23\) 問が正解から誤答へ転じる(正味 \(+4\)、\(1450\) 問不変)。SuperGPQA では \(49\) 対 \(79\)(正味 \(-30\)、\(1872\) 問不変)。査読は活動的であり、SuperGPQA では能動的に正味負である——表4の有意な C2 \(>\) C5 のギャップを反映する。我々はこれを有益遷移比 \(\mathrm{BTR} = \#\text{rescued} / (\#\text{rescued} + \#\text{harmed})\) として要約する。MMLU-Pro で \(0.54\)、SuperGPQA で \(0.383\)。(BTR は C2 対 C5 の問題ごとの遷移数から算出される。すべての回答改訂事象にわたる適合率ではない。それには査読誘発の編集すべての個別監査が必要となる。)
希釈批判によれば、ほとんどの問題が全員一致でありトポロジーが作用できないため、集約的 null は情報を持たないという。そこで不一致部分集合(初期回答が全員一致でないもの。MMLU-Pro:\(223\) 問、\(14.9\%\)。SuperGPQA:\(754\)、\(37.7\%\))と回復可能部分集合(正解が初期回答内に現れる不一致問題。\(59\)、\(3.9\%\)。\(234\)、\(11.7\%\))に限定する。表12は希釈反論を棄却するが、条件付きの主張を許容するものでもない。C5 は両ベンチマークで C3 に劣後する——MMLU-Pro の不一致・回復可能部分集合で \(3.1\)pp・\(13.6\)pp、対応する SuperGPQA の部分集合で \(2.0\)pp・\(1.7\)pp(SuperGPQA 回復可能での C5 対 C4:\(-3.4\)pp)。方向は両ベンチマークで一貫して負となったが、すべての信頼区間はゼロをまたぐ。トポロジーに作用の余地がある場所で、FPRR は利益を示さず、一貫した非有意のペナルティを示す。
| ベンチマーク | 部分集合 | \(n\) | C3 精度 | C5 精度 | C5\(-\)C3 (pp) | 95% CI (pp) |
|---|---|---|---|---|---|---|
| MMLU-Pro | 不一致 | 223 | 0.498 | 0.466 | \(-3.1\) | [\(-8.1\), \(+1.8\)] |
| MMLU-Pro | 回復可能 | 59 | 0.475 | 0.339 | \(-13.6\) | [\(-25.4\), \(+0.0\)] |
| SuperGPQA | 不一致 | 754 | 0.488 | 0.468 | \(-2.0\) | [\(-4.8\), \(+0.8\)] |
| SuperGPQA | 回復可能 | 234 | 0.402 | 0.385 | \(-1.7\) | [\(-8.6\), \(+5.1\)] |
本論文の問いに直接答えよう。最遠ペアエッジは、ランダム・最近接エッジがより少なくしか運ばなかった信号を確かに運んだ——真に誤った相手のより多くの検出である(MMLU-Pro の PEER INCORRECT 判定で \(301\) 対 \(254\)・\(260\)。検出率 \(0.212\) 対 \(0.202\)/\(0.192\))。それは検出率が下位十分位の \(3\)–\(10\times\) となる高距離十分位に集中していた。その信号の行方を3つの知見が要約する。(a) 意味距離は誤りへの曝露を確実に増加させる。曝露が修復と採用に伝播するかはレジーム依存である(MMLU-Pro:検出のみ。SuperGPQA:3 段階すべて)。そして逆方向連鎖はすべての段階で同じ距離でスケールする——したがって正味の利得は MMLU-Pro でゼロ、SuperGPQA で負となる(BTR \(0.54\) 対 \(0.383\))。(b) 査読は全問不正解問題の \(0\)–\(4\%\) で初期応答選択オラクルを超える新規正解を生成するが、エンドツーエンドのデリバリーは \(\le 1.5\%\) であり、ほとんどの提案は提案から採用の間に失われる。(c) 拘束条件は認識論的信用配分である。非対称な検証がなければ、システムは是正する不一致と誤反対を区別できない。「異なる」\(\neq\)「教示的」。
4 つの MMLU-Pro の問題(すべてシード 0)が上記で定量化したメカニズムを例示する。完全なトランスクリプト・距離行列・条件別最終結果は results/case_studies_mmlu_pro.md にある。
熱交換器設計の問題(正解:D)。4 つのエージェントは B、E、D、C と回答——誤った多数派(B)と単一の正解エージェント(2)である。C5 は \((0,1)\) と \((2,3)\) をペアにする。エージェント 2 はエージェント 3 を PEER INCORRECT と判定し、エージェント 3 は D に更新してエージェント 2 を支持する(PEER CORRECT)。合成器は D を回復する一方、C0・C1・C2・C9 はすべて多数派の B を出力する。これは設計通りに機能したパイプラインである——ただし注目すべきことに、ここでは C3・C4・C6 も D を回復しており、この成功は最遠ペアリング固有のものではない。
偏光板/半波長板スタックの問題(正解:J)。エージェント 0 と 1 はパース可能な回答を生成できず、エージェント 2 のみが J と回答し、エージェント 3 は C と回答する。C5(ペア \((0,1)\)、\((2,3)\))の下で、4 つの査読すべてが収束する。正解ペアの両エージェントが J を支持し、エージェント 2 がエージェント 3 を PEER INCORRECT と指摘し、全査読者が J に更新する。すべての集約条件が J を回復し、C0(エージェント 0)のみが誤りのままである。査読は脆弱な単一の正解サンプルをコンセンサスに転換する——しかしここでは単純な多数決も同じことをする(パース不能な回答は投票しない)。これもまた、トポロジーが活性成分でないことを示している。
管路流の動力に関する問題(正解:D)。3 つのエージェントが D と回答し、外れ値のエージェント 2 が A と回答する。最遠ペアリング(C5、C6 も同一)は外れ値を正しいエージェント 0 に配線する。外れ値はエージェント 0 を PEER INCORRECT と宣言して A を維持する。一方、エージェント 1 の正しい D を査読したエージェント 3 は H に切り替える。混乱した査読記録を前に、合成器は C5(および C3)で A を出力する——正しい多数派の破壊である——一方 C4 と C6 は D のままである。我々はこれを §7.3 の不安定化メカニズム——遠い相手が正しい回答への反対を製造する——の事例として提示するのであり、最遠ペアリングが系統的に誤った相手を選ぶことの証拠としてではない。集約レベルではそうではない(最大距離エッジの端点はベースレートで誤る)。
エネルギー保存の投射体問題(正解:I)。4 つのエージェントすべてが独立に A と回答し、ペアワイズ距離 \(0.099\)–\(0.243\) は純粋に、同じ誤った導出を異なる文言で正当化したことに由来する。すべての C5 査読は PEER CORRECT を返し、すべての条件——C0 から C9 まで——が A を出力する。埋め込み距離は言い回しを分離する。誤解は共有されているため、非相称査読はそれを追認する結果に終わる。
同一の初期応答・同一のプロンプト・同一の計算量の下では、相互査読の「誰が」は問題にならない。最遠ペア・最近接ペア・ランダム・厳密最大重みの各マッチングは、MMLU-Pro で互いに 0.6pp 以内、SuperGPQA で 0.4pp 以内に収まり、いずれも多数決や計算量整合自己査読を上回らない。これは、同質エージェント間の通信が集約を上回ることは稀であるという新興の描像 [6, 7] をルーティングの次元へ拡張する。付加価値をもたらさないのはブロードキャスト討論だけではない——同一サンプルのどのようなペアワイズ配線も同様である。
FPRR は、サンプリングされた回答が相関する推論クラスターを形成し、クラスター間でペアを組めば診断的コントラストが最大化されるという前提で設計された。前提は成り立つが、クラスターはルーティングで回避するには小さすぎる。MMLU-Pro では観測の \(85.1\%\) が全員一致であり(\(77.1\%\) が全員一致で正解、\(8.0\%\) が全員一致で誤り)、4 サンプル中のユニーク回答数の平均は \(1.166\)、ペアワイズコサイン距離の平均は \(0.087\) である。SuperGPQA はより争いがあるが、それでも低多様である(\(62.3\%\) が全員一致、\(1.355\) のユニーク回答、平均距離 \(0.095\))。4 つのうち 3 つのエージェントが同じことを言うとき、どのマッチング規則も1ペアの差を除いてほぼ同じエッジ集合を生成する——これは精度の表が示すとおりである。非相称ルーティングは利用可能な不一致の塊を前提とする。温度 \(0.8\)・強力なモデル・飽和したベンチマークでは、その塊は最小限である。
メカニズムの結果は、討論文献がしばしば混同する2つの量を分離する。意味距離は誤りへの曝露を頑健に増加させる。査読者は最上位距離十分位で最下位十分位より最大1桁多く誤った相手を指摘する。しかし、その曝露が修復と採用へ伝播するかはレジーム依存であり——MMLU-Pro では平坦、SuperGPQA では3段階すべてで有意——逆方向連鎖はあらゆる場所で同じ距離でスケールする。誤反対(最上位十分位で最大 \(0.10\))と正しい査読者の不安定化(MMLU-Pro で C5 下 \(4\%\)、C3 下 \(2\%\) の問題)である。注目すべきは、逆方向連鎖は最遠ペアリングが悪い相手を選ぶことでは説明されない点である。最大距離エッジの端点はベースレートで誤る。このレジームで査読ベースのパイプラインを縛るのは認識論的信用配分である。遠く、自信に満ちて論じられた回答は、誤りを是正する場合でも異議をでっち上げる場合でも、査読者と合成器には同じに見える。したがって非対称な検証がなければ、トポロジーが獲得する曝露の1単位ごとに不安定化として返済される。
複数サンプル条件が単一ベースラインを実際に上回る場所——最も明確なのは SuperGPQA で、すべての \(N{=}4\) 条件が C0 を \({\approx}+4\)pp 上回る——その利得は多数決と査読なし合成に等しく取り込まれる。実際、SuperGPQA では査読なし合成が相互査読を有意に上回る(C2 対 C5:\(+1.5\)pp、\(p=0.010\) 未補正)。より難しいベンチマークでは、査読は査読なしより測定可能なほど悪い。我々の結果のどこにも、相互査読がモデルの知っていることを変えるという示唆はない。それはモデルがすでに生成する回答に重みを付け直すのであり、これらのベンチマークでは多数決も5分の1のトークンコストで同じくらいうまく重み付けし直す。査読ベース・討論ベースの利得の報告は、計算量整合の自己査読コントロールと多数決の下駄に照らして読むべきである。我々のデータでは、その両方が効果を完全に説明する。
いくつかの妥当性への脅威がこれらの知見を限定する。
計算オーバーヘッド。査読条件は多数決の \({\sim}5\times\)、単一応答の \({\sim}20\times\) のトークンを要し、集約利得はゼロである。我々のコスト分析は記述的であり、より安価な査読変種(より短い査読、より少ないペア数)は検証していない。
相関誤差は構造的である。すべてのエージェントは1つのプロバイダが提供する1つのチェックポイントであるため、同源の相関誤差(共有された誤解、観測の \(8.0\%\)–\(21.6\%\))が、モデル内査読スキームが回復しうる範囲を制約する。異種モデルプールは異なる振る舞いをするかもしれない。
ベンチマークのコンタミネーション。MMLU-Pro と SuperGPQA は公開ベンチマークであり、訓練データに部分的に露出している可能性がある。コンタミネーションは絶対精度を押し上げ、ヘッドルームを圧縮する。すべての条件に同一に適用されるためペア差は解釈可能なままだが、検出可能な効果量は残されたヘッドルームによって制約される。
埋め込みへの依存。距離は結論+正当化テキストに対する単一エンコーダ(bge-m3)に由来する。埋め込み距離は表層的意味的非類似性を測るのであり、論理的不一致ではない——qid 10012 は距離 \(0.24\) で同一の誤解を示した。探索的な指標アブレーション(表6)はこれを部分的にしか緩和しない。単一シード・ベンチマークあたり 200 問であり、MMLU-Pro D4 が欠けているため、SuperGPQA での D4 の優位は、一次の null に対抗する証拠となりうる前に再検証を要する。
判定者と合成器のバイアス。合成器はエージェントと同一モデルであり、バイアスを共有しうる(例えば、自信ある回答や冗長な回答への偏り)。プロンプトは条件間で凍結されているため、このバイアスは条件差を説明できないが、すべての査読条件の結果を形作る。
単一モデル・単一デコード設定。本実行では1つのチェックポイント、1つの温度(\(0.8\))、1つの \(N\) である。プロバイダはシードパラメータを公開しないため、API の非決定性はシード固定できない(我々が制御するすべての確率的要素——サンプリング・ペアリング・シャッフル——はシード付きでログ記録される)。不一致の塊が大きい、より多様性の高いレジーム(より高い温度・異種アンサンブル・より難しいか飽和度の低いタスク)へは、この null は移行しないかもしれない。
範囲と依存性。2 つのベンチマーク。SuperGPQA は 4 シードに依拠する(MMLU-Pro は 3)。シード間観測は問題を共有するため、プールされたブートストラップ CI と McNemar \(p\) 値は軽度に反保守的である——これはむしろ一次比較について null 結論を保守的にするものであり、一次比較のいずれも有意に近くはない。事前登録された \(N\) アブレーションとペアリングシード分散研究(修正 8)は予算の都合で未実行のため、null が \(N\) やペアリングのランダム性にどの程度敏感かを定量化できない。距離アブレーションは単一シードである。
事前登録された判定基準の下で、本研究は結果カテゴリ D——null 結果に分類される。同一のキャッシュ済み応答上で、最遠ペア相互査読は、MMLU-Pro(最終、3 シード)と SuperGPQA(4 シード)において、ランダムペアリング・最近接ペアリング・厳密最大重みマッチング・多数決・計算量整合自己査読と統計的に区別がつかない。すべての一次効果量は \(\pm 1\)pp 以内、すべての Holm 調整済み \(p\) 値は \(\geq 0.92\) である。誰が誰を査読するかは問題にならない——このレジームでは。むしろ、より難しいベンチマークでは査読は査読なしよりわずかに悪い(C2 \(>\) C5 は \(1.5\)pp、\(p=0.010\) 未補正)。1 つの探索的知見はこの分類を限定するが、変更はしない。単一シードの距離アブレーションで、不一致感知型の NLI 矛盾指標(D4)はより難しいベンチマークで純粋な意味距離を上回る(D4 \(-\) D2 \(= +3.0\)pp、CI \([+0.5, +6.0]\)、不一致 \(7\) 対 \(1\)。表6)——認識論的対立こそがテキストの相違ではなくルーティングに値する量であることを示す最初の手がかりであり、この null を不一致感知ルーティングの研究へ接続する。
メカニズム分析こそが、我々が信じるところの永続的な貢献である。意味距離は両ベンチマークとすべてのペアリング規則で誤りへの曝露を確実に増加させるが、曝露が修復と採用に伝播するかはレジーム依存であり——誤反対と不安定化の逆方向連鎖はすべての段階で同じ距離でスケールするため、正味の利得はゼロかそれ以下となる。査読は冗長でも、初期回答集合に制約されるものでもない。両方向に問題を転じ(BTR \(0.54\) / \(0.383\))、全問不正解問題の \(0\)–\(4\%\) で新規正解を生成するが、その新情報のエンドツーエンドのデリバリーは \(\le 1.5\%\) である。同質エージェント間の相互査読が失敗するのは、査読者に不一致が見えないからでも、新しく言えることが何もないからでもない——システムが信用を配分できないからである。非対称な検証がなければ、是正する不一致と誤反対は区別できない。
3 つの方向が導かれる。第一に、不一致の塊が実在する場所で非相称ルーティングを再検証すること。より高い温度または異種モデルのプール、飽和度の低いタスク、より大きな \(N\) である。第二に、ルーティングの前に安定化すること。距離誘発の誤反対から正解を守る(例えば、判定条件付き合成や挑戦の非対称的検証)、不安定化連鎖を直接標的とする。第三に、認識論的信用配分そのものを研究対象とすること——査読者のキャリブレーション、提案から採用へのデリバリー、衝突する査読下での裁定——である。我々のファネルと段階別回帰は、ルーティングではなく信用配分こそが査読ベースのテスト時スケーリングの拘束条件であることを特定しているからである。
キャッシュされた生レコード(JSONL:完全なプロンプト・生出力・パース済みフィールド・トークン使用量・シード)、分析出力、図データはプロジェクトリポジトリで公開している。ベンチマークデータセットは公開である:MMLU-Pro(CC-BY-4.0)および SuperGPQA(ODC-BY)。
完全な実験パイプラインと分析スクリプト(シード付きペアリング・決定論的パース・ペアブートストラップ統計)はプロジェクトリポジトリで公開している。
全著者は研究の構想と設計、実験の実行、データ分析、原稿作成に貢献し、最終版を承認した。
本研究は Gi (Beijing) Tech Design Ltd. により実施・資金提供された。外部資金は受けていない。
全著者は Gi (Beijing) Tech Design Ltd. の従業員である。
該当なし。本研究はヒト参加者・動物・個人特定可能データを含まない。