誰が誰をレビューすべきか?
テスト時のLLM推論のための、回答条件付き異配ピアレビュー
李锐 · 孙成龙 · 郑学燕 · 刘丹
际和(北京)科技有限责任公司 · 2026-09
複数のAIに互いの「宿題」を採点させることは、今や業界の常套手段です。しかし、あまり深く問われてこなかった問いがあります——誰が誰を採点すべきか? 私たちは同じ回答群を異なる方式でペアにして相互レビューさせ、2つの公開ベンチマークで3,500問・約14万回の呼び出しからなる対照実験を行いました。その答えはコスト削減に役立ちます:ペアリング方式は最終結果に影響しません——最も意見の合わない2つを組ませても、ランダムに組むのと変わらないのです。
3つの発見
「最も違う」は「最も教訓になる」ではない
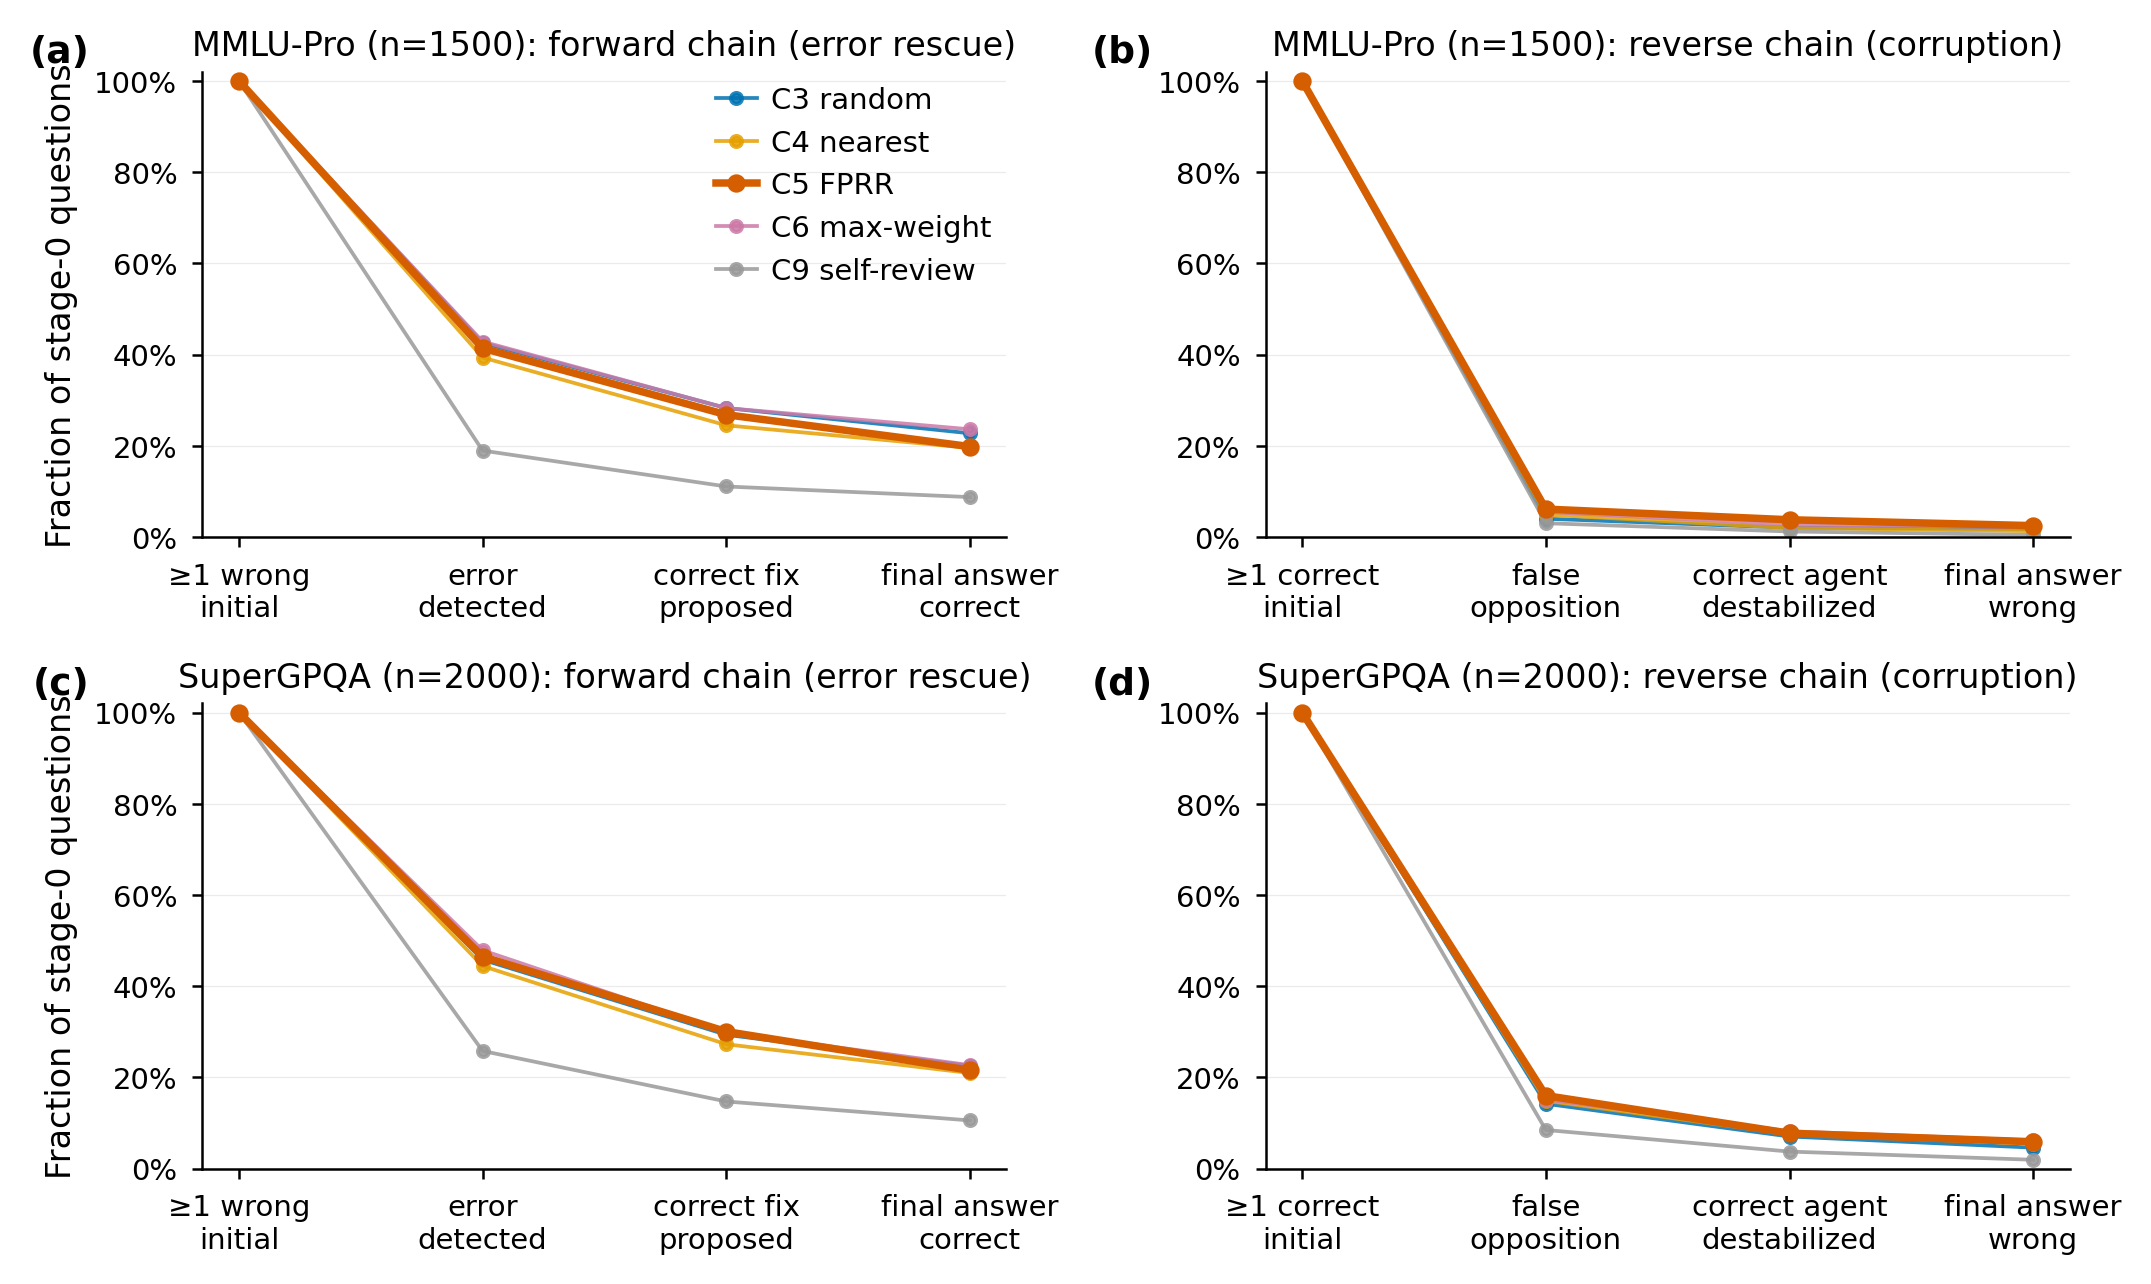
最遠ペアリングは確かに、AIが仲間の誤りをより頻繁に発見するようにします——検出率は意味的距離とともに単調に上昇し、最上位と最下位の十分位の差は一桁に達します。しかし誤りの発見は訂正ではありません——検出の後、正しい修正を提案できるか、その修正が採用されるかは、距離と無関係でした。間違いを見つける力は上がったのに、直す力は上がらなかったのです。
レビューは活発、しかし正味効果はゼロ
誤った回答が1つ訂正されるたびに、もともと正しかった別の回答が「誤った反対」に流され、2つの方向はほぼ正確に相殺されます。より難しいベンチマークでは、相互レビューを行わず候補回答をそのままシンセサイザーに渡す方が、むしろ有意に良い結果になりました(+1.5ポイント、p=0.010)。相互レビューは無料の中立ステップではありません——間違った場所では純粋なコストです。
ボトルネックはクレジット・アサインメント
相互レビューは時折、4つの初期回答のどれにも存在しない正解を生み出します——新しい情報は確かに存在します——しかし最終的に採用されるのは1.5%未満です。システムは「訂正的な不一致」と「誤った反対」を区別できません。不一致を検証可能な小さな問いに変えることが、次世代システムの課題です。
こうしたシステムを作る方へ
多数決と直接合成の組み合わせは、5分の1のトークンコストで、すべてのレビュー・トポロジーと同じ精度を達成します。浮いた予算はルーティングの工夫ではなく、キャリブレーションと検証に使いましょう。
全文と資料
引用
@misc{fprr2026,
  title  = {Who Should Review Whom? Response-Conditioned Disassortative Peer Review for Test-Time LLM Reasoning},
  author = {Li, Rui and Sun, Chenglong and Zheng, Xueyan and Liu, Dan},
  year   = {2026},
  month  = sep,
  note   = {Gi (Beijing) Tech Design Ltd.}
}
今後
次の実験は「誰が誰と議論するか」ではなく、「不一致の中で誰が信頼できるかをどう見分けるか」を問います:候補回答と予算を固定し、検証者が候補回答を見られるかどうかだけを変え、「目隠し」が誤った反対を遮断できるかを検証します。設計は凍結済みで、結果は同じ形で公開します。