研究 · 2026年9月
AIを自分のパソコンに入れる
Qwen、Jev、LayaからComfyUIまで、そして2台の普通のマシンでの実測
2026-09
ローカルで動く大規模モデルには何があるのか?言語、推論、画像、動画、全部あるのか?2026年9月時点で代表的なローカルモデルを並べ、48GBユニファイドメモリのMac miniと16GB VRAMのRTX 3080 TiノートPCという2台の普通のマシンに実際にインストールして動かし、数字も落とし穴も記録しました。
3つのポイント
モデルの大きさと重要性に単純な関係はない
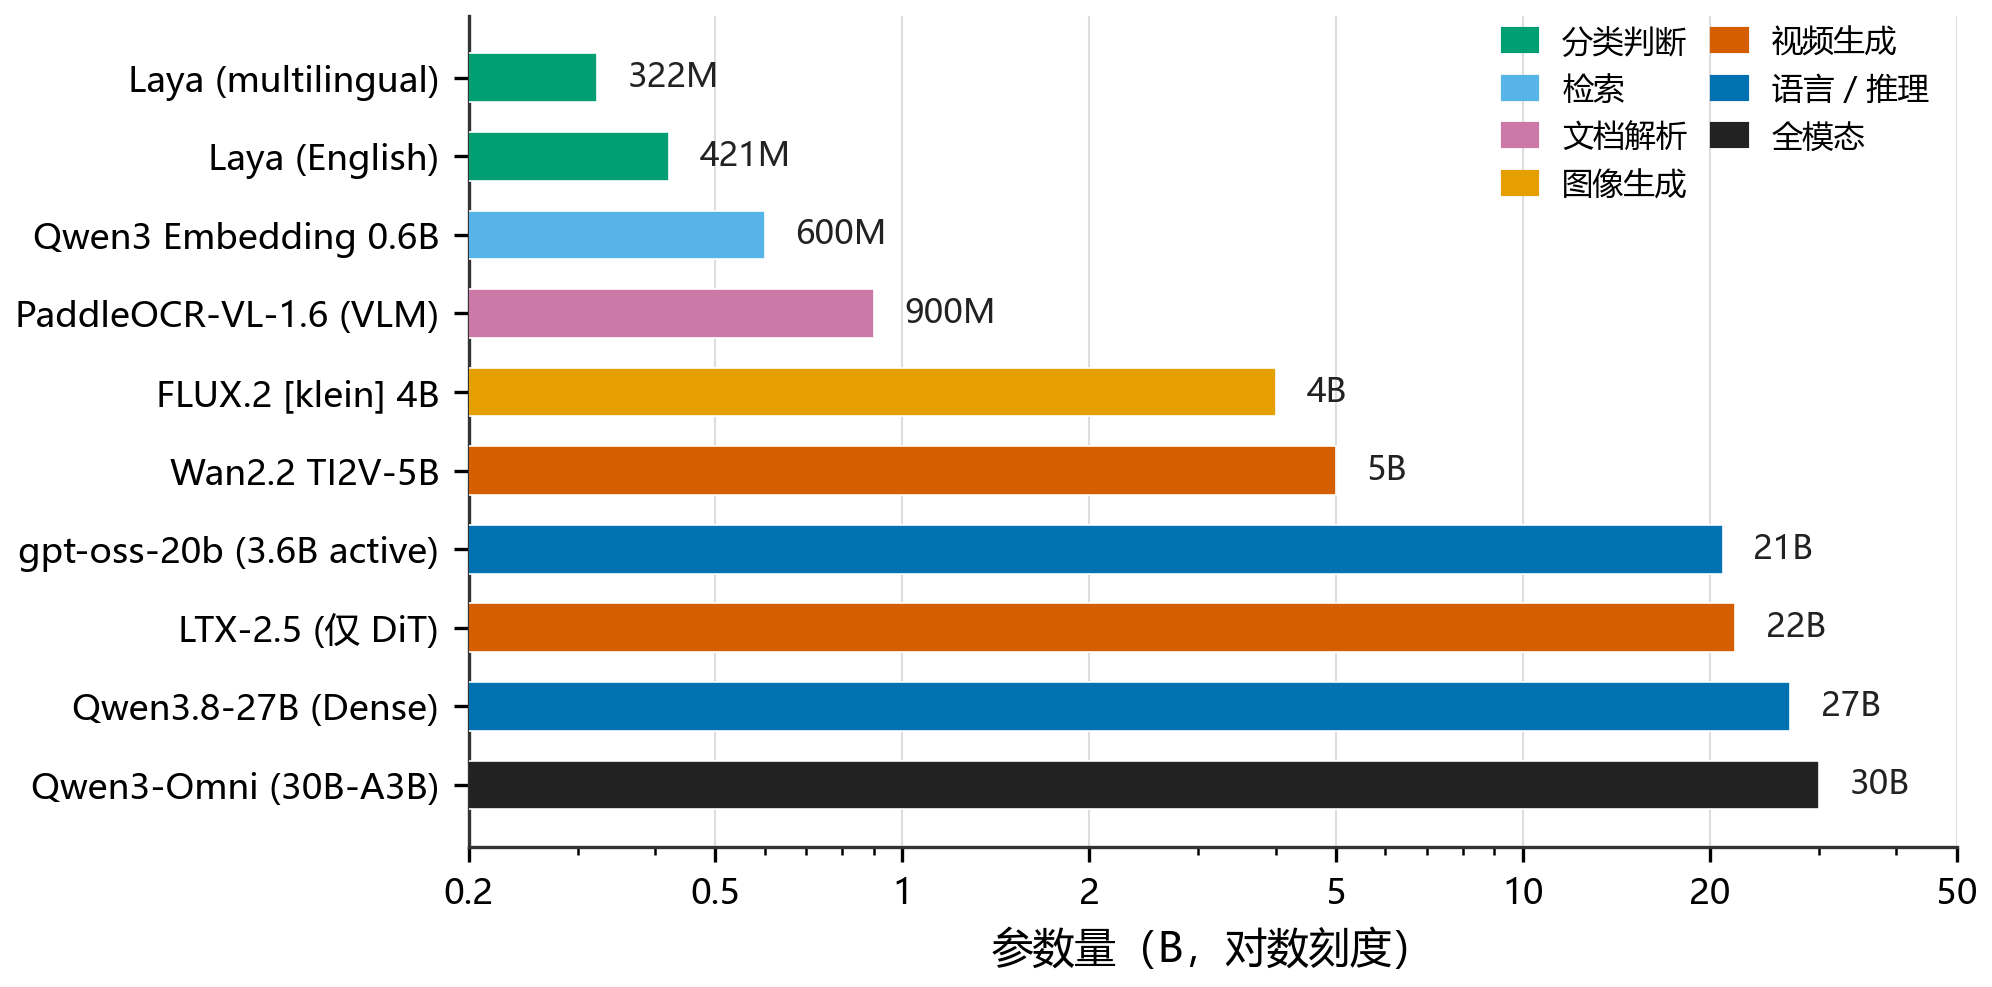
322Mの分類モデルから30Bの全モダリティモデルまで、幅は約2桁。契約書から表や印章を抜き出すだけなら0.9Bの専用モデルで足りますが、6秒の動画はハイエンドGPUを何分も占有します。AIは少しずつ道具箱の様相を呈してきました。
16GB VRAMが22Bの動画モデルを動かした
48GBユニファイドメモリのMacはLLMには最適ですが、この動画ワークフローは動きませんでした——int8加速がCUDAカーネルに依存し、MPSに相当する最適化がないためです。16GB VRAMの3080 TiノートPCは、ComfyUI DynamicVRAMが収まらない重みを64GBのシステムメモリにオフロードし、22BのLTX-2.5を無理やり動かしました:6秒・1152×640の動画で1本約6.2分。
「全方位」とは役割分担であり、何でもできる1つのモデルではない
同じマシン、同じ27Bモデルでも、量子化・エンジン・デコード方式を変えると速度は約2倍になりました(omlx + MTPで22.2 token/s)。ローカルで動くことと、すべてをローカルに置くべきことは別です——大量生産は最終的にクラウドへ。全方位とは、それぞれが誰に仕事を渡すべきかを知っていることなのかもしれません。