Installer l'IA sur sa propre machine
De Qwen, Jev et Laya à ComfyUI — essais concrets sur deux machines ordinaires
2026-09
Quels grands modèles peuvent réellement tourner en local — langage, raisonnement, images, vidéo ? Nous avons aligné les modèles locaux représentatifs de septembre 2026, puis les avons installés et exécutés sur deux machines ordinaires : un Mac mini à mémoire unifiée de 48 Go et un portable RTX 3080 Ti de 16 Go de VRAM, en notant les chiffres comme les embûches.
Trois points clés
La taille d'un modèle n'a pas de relation simple avec son importance
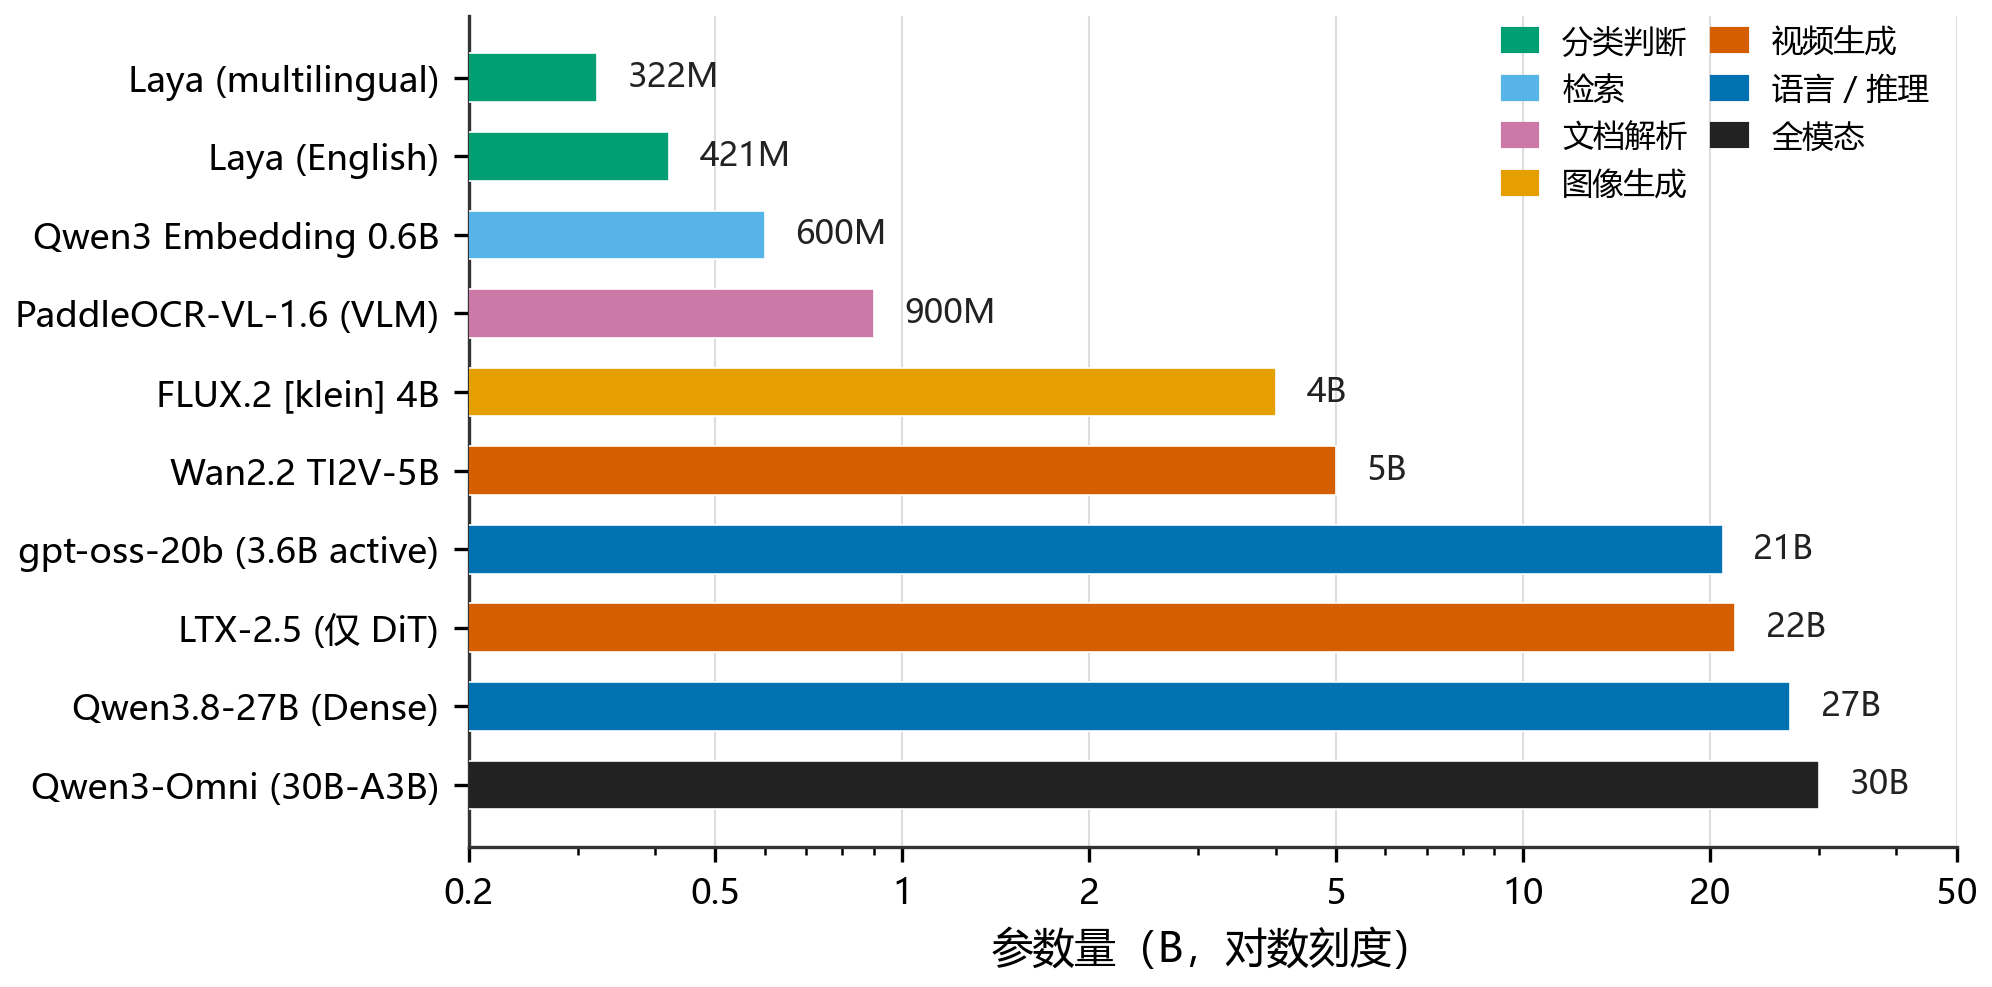
D'un classifieur de 322M à un modèle omni de 30B, l'écart frôle deux ordres de grandeur. Extraire les tableaux et les sceaux d'un contrat ne demande qu'un modèle dédié de 0,9B ; une vidéo de six secondes, elle, occupe un GPU haut de gamme pendant des minutes. L'IA prend peu à peu des airs de boîte à outils.
16 Go de VRAM ont fini par faire tourner un modèle vidéo de 22B
Le Mac à mémoire unifiée de 48 Go est excellent pour les LLM, mais ne fait pas tourner ce pipeline vidéo — l'accélération INT8 repose sur des noyaux CUDA sans équivalent MPS. Le portable 3080 Ti de 16 Go, grâce à ComfyUI DynamicVRAM qui décharge les poids excédentaires vers 64 Go de mémoire système, a fait tourner le LTX-2.5 de 22B : environ 6,2 minutes par clip de 6 secondes en 1152×640.
« Complet » veut dire répartition des rôles, pas un modèle qui sait tout faire
Même machine, même modèle 27B : en changeant la quantification, le moteur et le décodage, la vitesse a environ doublé (omlx + MTP à 22,2 tok/s). Tourner en local ne signifie pas que tout doit rester en local — la production en série est finalement partie vers le cloud. Être complet, au fond, c'est peut-être simplement que chacun sait à qui passer le travail.
Texte intégral
Données au 22 septembre 2026. Le texte intégral est disponible en chinois uniquement.