研究 · 2026 年 9 月
谁应审谁?
回答条件化的异配互审,用于测试时大模型推理
李锐 · 孙成龙 · 郑学燕 · 刘丹
际和(北京)科技有限责任公司 · 2026-09
让几个 AI 互相批改作业,已经是行业里的常规做法。但有一个少有人细问的问题:谁批改谁?我们把同一批回答按不同方式配对互审,在两个公开基准上做了 3,500 道题、约 14 万次调用的受控实验。答案可以帮你省钱:配对方式对最终结果没有影响——把意见最不合的两个安排在一起,并不比随机安排更好。
三个发现
「最不同」不等于「最有教益」
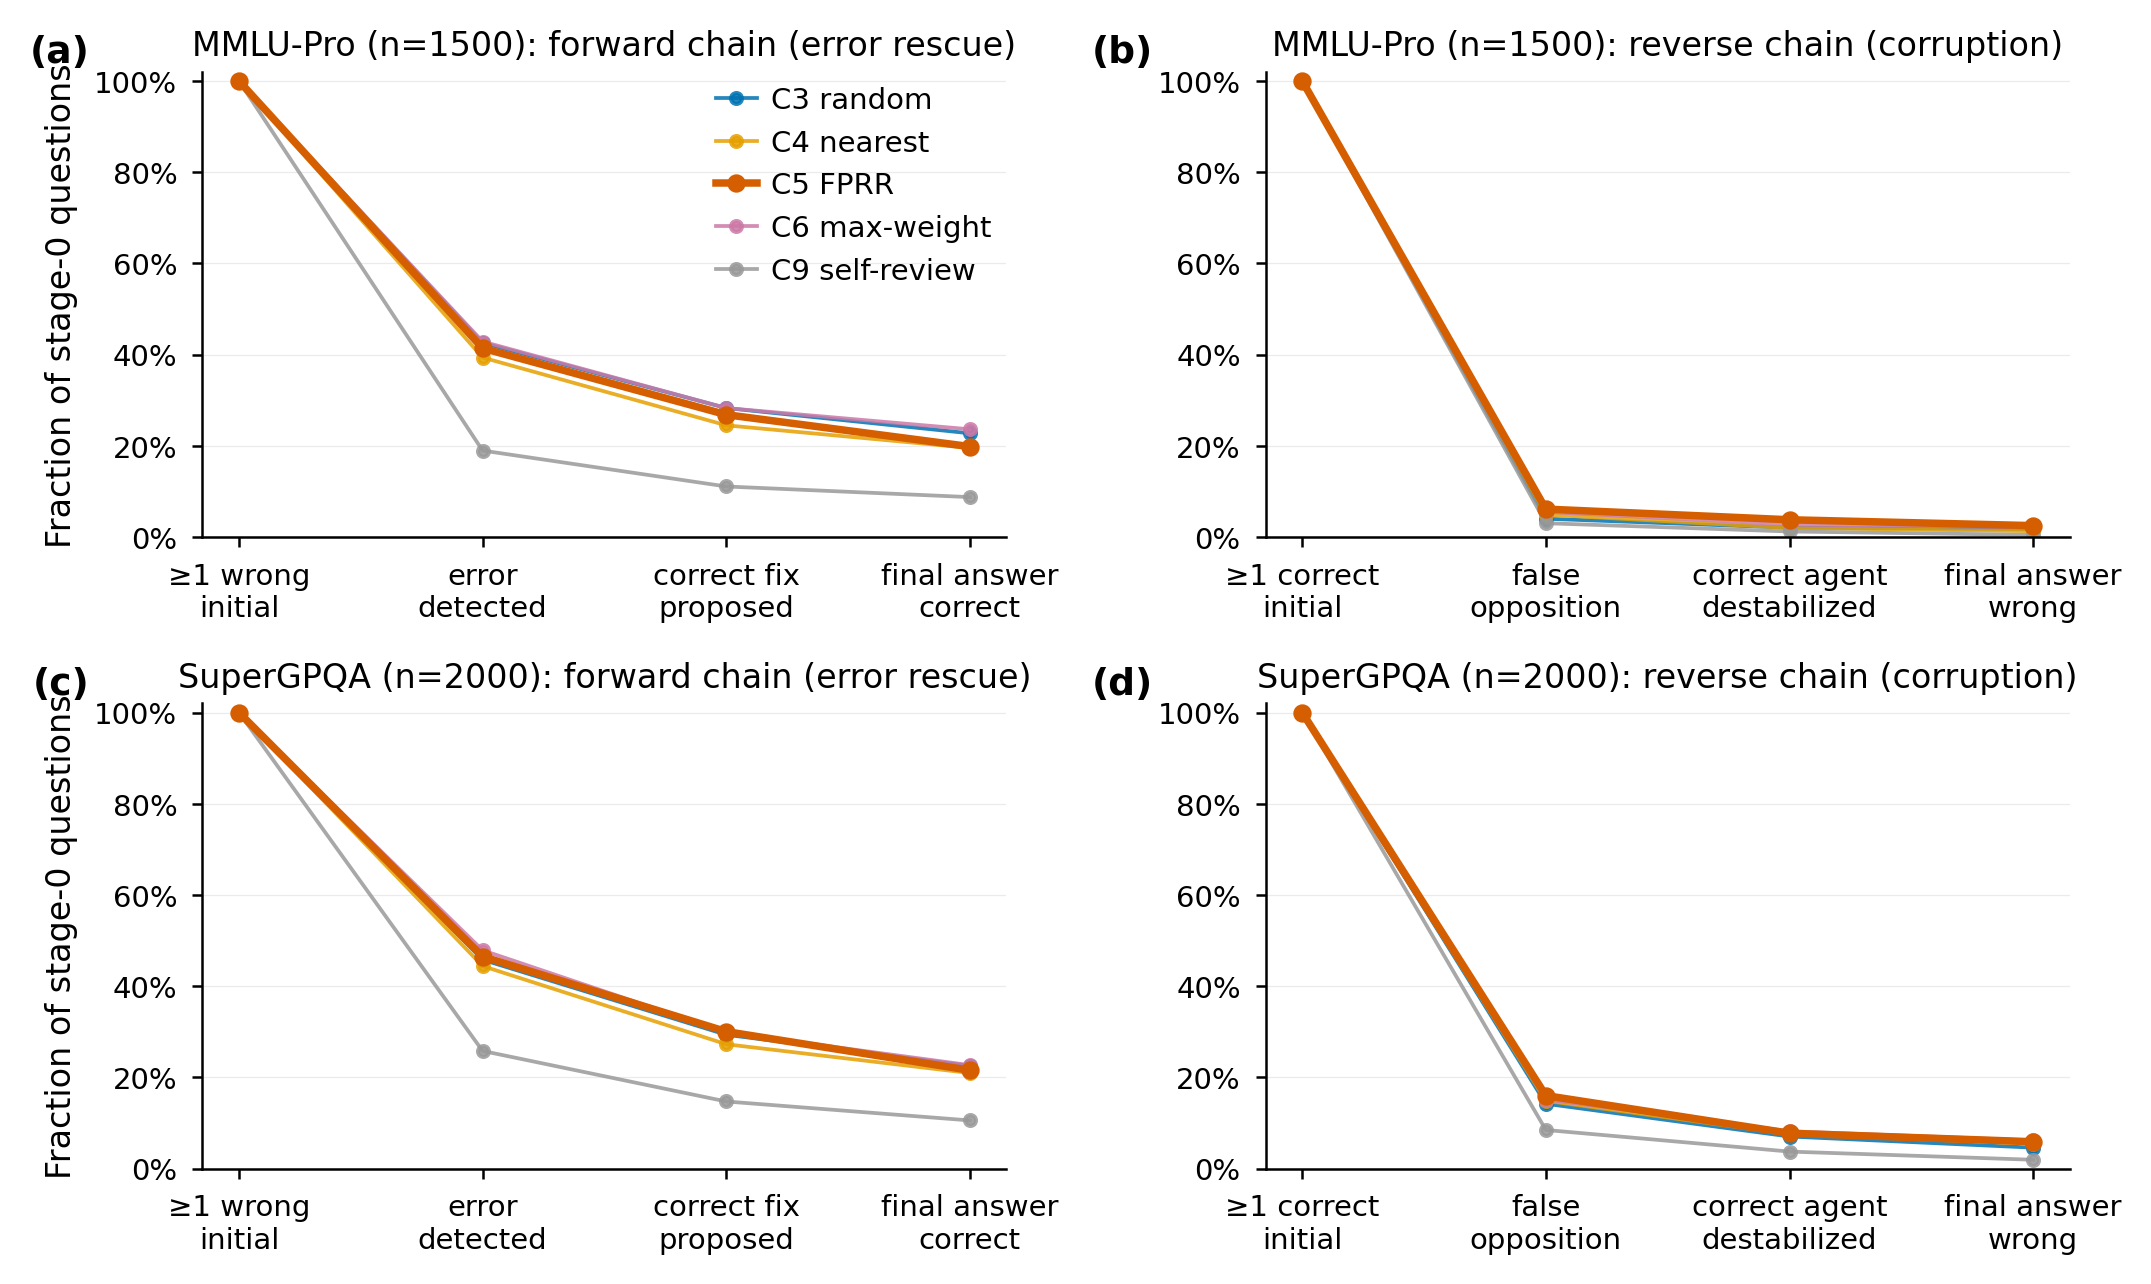
最远配对确实让 AI 更经常发现同伴的错误:检出率随语义距离单调上升,最高与最低十分位相差一个数量级。但发现错误不等于改正错误——检出之后,能否提出正确修复、修复能否被采纳,与距离无关。挑错的本事涨了,改错的本事没涨。
互审活跃,但净效应为零
每纠正一个错误答案,就有另一个原本正确的答案被「错误反对」带偏,两个方向几乎精确抵消。在更难的基准上,不做互审、直接把候选答案交给合成器,反而显著更好(+1.5 个百分点,p=0.010)。互审不是免费的中性步骤,在错误的地方它是一笔净成本。
瓶颈是信用分配
互审偶尔能提出四个初始答案里都没有的正确答案——新信息确实存在——但最终被采纳的不到 1.5%。系统分不清「纠正性分歧」与「错误反对」。让分歧变成可验证的小问题,是下一代系统该解决的事。
对做这类系统的人
多数投票加直接合成,用五分之一的 token 成本拿到与所有互审拓扑相同的准确率。把省下来的预算花在校准与验证上,而不是路由花样上。
全文与材料
引用
@misc{fprr2026,
  title  = {Who Should Review Whom? Response-Conditioned Disassortative Peer Review for Test-Time LLM Reasoning},
  author = {Li, Rui and Sun, Chenglong and Zheng, Xueyan and Liu, Dan},
  year   = {2026},
  month  = sep,
  note   = {Gi (Beijing) Tech Design Ltd.}
}
后续
下一步实验不再研究「谁和谁讨论」,改研究「分歧里怎么分出谁可信」:固定候选答案与预算,只改变验证者能否看到候选答案,检验「蒙眼」能否阻断错误反对。设计已冻结,结果出来照旧公开。